
テストが「たまに落ちる」のはなぜ? ― フレークの正体を小さな実験で確かめる
同じコードなのに、赤くなったり緑になったりするテスト
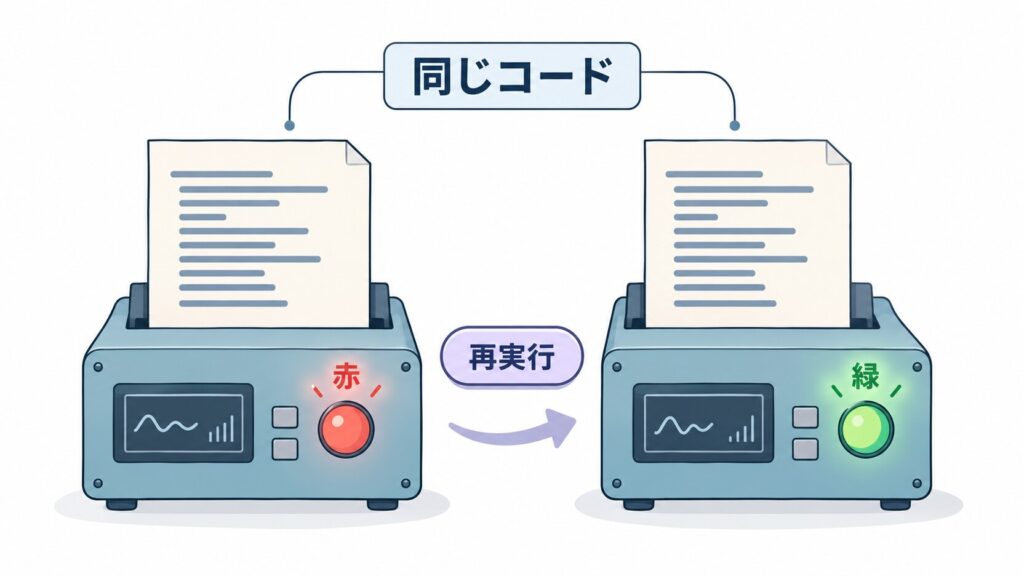
コードの変更を送る push をしたら、CI が赤くなりました。実行結果の記録(ログ)を開いても、コードの変更とは関係なさそうな失敗です。半信半疑で「再実行」を押すと、今度は緑になりました。
コードは1行も変えていません。それなのに、なぜ結果が変わったのでしょうか。この記事では、この現象の正体を、いくつかの小さな実験で確かめていきます。
目次
こういうテストには名前がある
同じコードに対して、成功も失敗も出すテストのことを、フレーク(flaky)なテストと呼びます。Google が公開している記事では、まさにこの意味で定義されています。気まぐれなテストのことだと思えば大丈夫です。
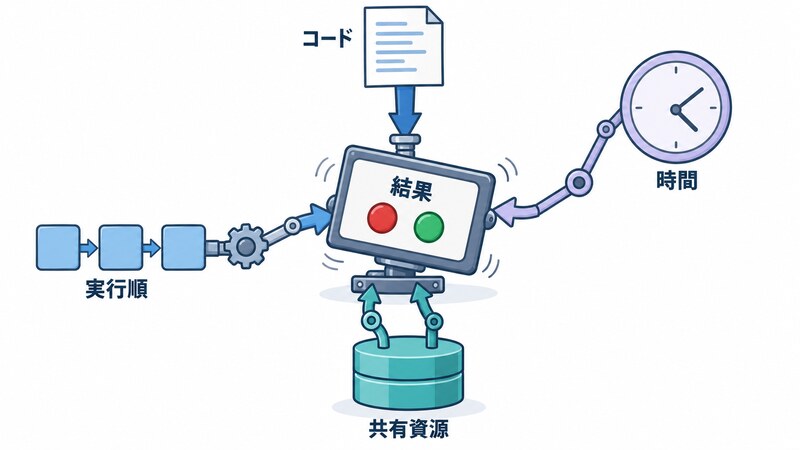
大事なのは、結果が変わった理由です。テストの結果は「コード」だけで決まるのが理想ですが、フレークなテストは、コード以外の何かにも依存しています。つまり、フレークの正体は「テストが、コード以外のものに依存していること」です。
Google の記事は、原因として、複数の処理が同時に走ること(並行性)、実行のたびに結果が変わりうる挙動(非決定的な挙動)への依存、実行する環境の問題(インフラ要因)などを挙げています。ここから先の「実行順」「共有資源」「時間」という3分類は、手元で再現しやすいものを選んで、この記事の筆者が整理した呼び方です。Google の分類そのものではありません。
以降の実験は、すべて Node.js v22.12.0 の標準テストランナー(node:test。テストを見つけて実行し、結果をまとめる道具)で、Windows 11 のマシンで行いました。数字はこの環境での値で、別のマシンでは大きく変わります。
1つ目の原因:前のテストが残したものに頼っている
最初の例は、実行順です。次のテストは、1つ目が積んだ商品を2つ目が前提にしています。
import test from 'node:test';
import assert from 'node:assert/strict';

const cart = [];

test('adds an item', () => {
  cart.push('apple');
  assert.equal(cart.length, 1);
});

test('cart has one item', () => {
  assert.equal(cart.length, 1);
});
ファイル全体を実行すれば、2件とも通ります。ところが2つ目のテストだけを名前で指定して実行すると、1つ目が走らず cart が空のままなので落ちます。
$ node --test order.test.js
# pass 2
# fail 0

$ node --test --test-name-pattern="cart has one item" order.test.js
not ok 1 - cart has one item
  expected: 1
  actual: 0
# pass 0
# fail 1
上の出力は抜粋です。この例は、実行順が毎回同じなら、毎回同じ結果になります。つまり「たまに」ではなく決定的に再現します。ただし、実行のたびに順序が入れ替わる環境では、同じテストが通ったり落ちたりするはずです。この記事ではそこまでは実測していませんが、順序への依存が潜んでいるテストは、そういう形で顔を出すと考えてください。
2つ目の原因:同じものを同時に触っている
次は共有資源です。Node.js v22 のテストランナーは、既定では、テストファイルをそれぞれ別のプロセスで並列に(同時に)実行します。そのため、2つのファイルが同じ一時ファイルを書き換えると、お互いの書き込みを読んでしまうことがあります。
import test from 'node:test';
import assert from 'node:assert/strict';
import fs from 'node:fs/promises';
import os from 'node:os';
import path from 'node:path';

const file = path.join(os.tmpdir(), 'flaky-sandbox-shared.txt');

test('shared-a writes and reads back its own value', async () => {
  for (let i = 0; i < Number(process.env.ITER ?? 50); i++) {
    await fs.writeFile(file, 'value-from-a');
    const text = await fs.readFile(file, 'utf8');
    assert.equal(text, 'value-from-a');
  }
});
これが shared-a.test.js です。shared-b.test.js は、書き込む値が value-from-b になるだけの同じ形のファイルです。自分で書いた値をそのまま読み戻すだけなので、1つだけで動かせば落ちる理由がありません。
「たまに落ちる」を見るには、同じ実行を何十回もくり返して数えるのが手っ取り早い方法です。そこで、N回起動して、not ok で始まる行から失敗したテスト名を数える小さなプログラム run-many.js を使いました。骨子は次のとおりです。
import { spawnSync } from 'node:child_process';

const runs = Number(process.argv[2]);
const files = process.argv.slice(3);
const perTest = {};
let failingRuns = 0;
for (let i = 0; i < runs; i++) {
  const r = spawnSync('node', ['--test', '--test-reporter=tap', ...files], { encoding: 'utf8' });
  const failed = [...r.stdout.matchAll(/^not ok \d+ - (.+)$/gm)].map((m) => m[1]);
  if (failed.length > 0) failingRuns++;
  for (const name of failed) perTest[name] = (perTest[name] ?? 0) + 1;
}
console.log(JSON.stringify({ runs, failingRuns, perTest }, null, 2));
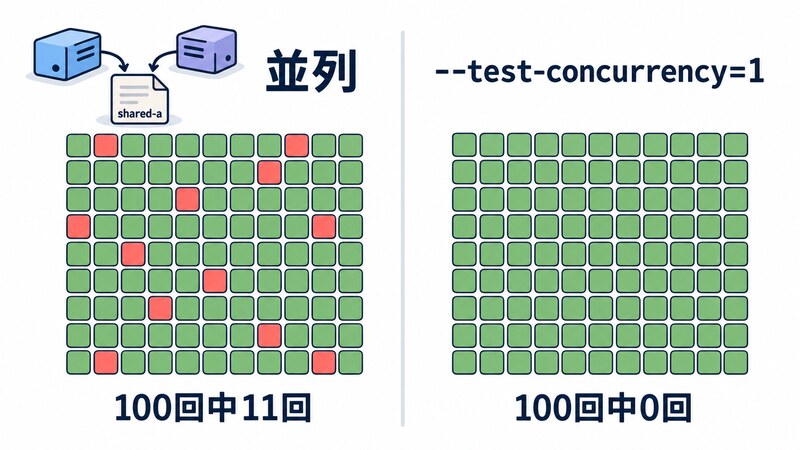
この2ファイルだけを、反復回数 ITER=10 として並列で100回実行すると、11回落ちました。--test-concurrency=1 を付けて同時実行数を1にすると、100回とも通りました。出力は抜粋です。runs は実行した回数、failingRuns は失敗が1件以上あった回数、perTest はテスト名ごとの失敗回数を表します。
### shared only, parallel, ITER=10
  "runs": 100,
  "failingRuns": 11,
  "perTest": { "shared-a writes and reads back its own value": 11 }

### shared only, --test-concurrency=1, ITER=10
  "runs": 100,
  "failingRuns": 0,
  "perTest": {}
--test-concurrency=1 は、テストファイルを同時に1つしか走らせない指定です。ただし、これは競合が起きない状態にしただけです。並列を止めて競合を避ける暫定回避で、共有ファイルを使っているという原因は、そのまま残っています。
では、根本的にはどう直せばよいのでしょうか。テストごとに専用のファイル名を使うことです。
試しに、shared-a.test.js との差はファイル名とテスト名だけという own-a.test.js と own-b.test.js を作り、並列のままで100回実行すると、100回中0回の失敗でした。競合の余地そのものがなくなったためと考えられます。ただし、100回では「たまたま0回だった」可能性を完全には排除できません。
先ほどの shared-a と shared-b の2ファイルだけで100回回した実測では、落ちたのは shared-a だけで、shared-b は落ちませんでした。理由は調べていないので、ここでは触れません。なお、次の節で出てくる300回の実行では、shared-b も2回落ちています。
3つ目の原因:時間に余裕がない
最後は時間です。「この処理は 100 ミリ秒以内に終わる」というアサーションは、一見まじめなテストに見えます。しかし処理にかかる時間は、同じマシンでも毎回少しずつ違います。
import test from 'node:test';
import assert from 'node:assert/strict';

const limitMs = Number(process.env.LIMIT_MS ?? 50);

test('sorting 200k numbers finishes within the limit', () => {
  const data = Array.from({ length: 200_000 }, () => Math.random());
  const start = performance.now();
  data.sort((x, y) => x - y);
  const elapsed = performance.now() - start;
  assert.ok(elapsed < limitMs, `took ${elapsed.toFixed(1)} ms, limit ${limitMs} ms`);
});
事前に30回、単独で計ったところ、中央値(小さい順に並べたときの真ん中の値)は 75.2 ms でした(最小 67.9、最大 100.3)。そこで上限は、中央値より少し上の LIMIT_MS=100 に置きました。
この上限で、先ほどの共有ファイルのテストも含めた3ファイル全体を100回実行すると(ITER=3)、並列で17回落ちました。同時実行数を1にして他のテストと競わせなくすると、9回に減って見えます。ただし、17回と9回はそれぞれ1セットずつの実測なので、ばらつきの範囲かもしれません。負荷を減らすと下がると断定はできず、減ってもゼロにはならなかった、というところまでが言えることです。上限が処理時間のばらつきの大きい側に近いので、落ちる回があるのだと考えられます。
### parallel (default)
  "failingRuns": 17,
  "perTest": { "sorting 200k numbers finishes within the limit": 17 }

### --test-concurrency=1
  "failingRuns": 9,
  "perTest": { "sorting 200k numbers finishes within the limit": 9 }
同じマシンのほかの処理にも影響されるので、割合は実行のたびに変わります。別の回(ITER=10)では、同じ時間のテストが100回中21回落ちました。割合が一定しないこと自体が、フレークらしさです。
確かめる方法:何十回も回して、どれが落ちたかを見る
では、フレークかどうかはどう確かめればよいのでしょうか。答えは単純で、コードを変えずに同じテストを何十回も回して、落ちる割合を数えることです。ここまでの「100回中11回」「100回中17回」は、すべてこのやり方で出した数字です。
割合は、環境しだいで大きく変わります。3ファイル全体を並列で回す同じ設定(ITER=10)でも、100回中3回しか失敗しなかった回があれば、300回中127回も失敗した回もありました。ほかのプロセスが動いていたかどうかなど、マシンの負荷しだいと考えられますが、原因の切り分けはしていません。つまり、一度の数字を信じず、回数を重ねて割合で見ること、そして割合は環境で変わると知っておくことが大切です。
数えるときに気をつけたいのは、失敗の件数だけを見ないことです。上の300回の実行の結果は、次のとおりでした(出力は抜粋です)。
  "runs": 300,
  "failingRuns": 127,
  "perTest": {
    "shared-a writes and reads back its own value": 39,
    "sorting 200k numbers finishes within the limit": 111,
    "shared-b writes and reads back its own value": 2
  }
by failure count {"0":173,"1":102,"2":25}
{"pairsWithSameNonZeroCount":5451,"ofWhichDifferentMembers":1422}
なお、最後の2行は、各回の失敗テスト名を記録して別に集計した値で、後ほど示す骨子には含めていません。
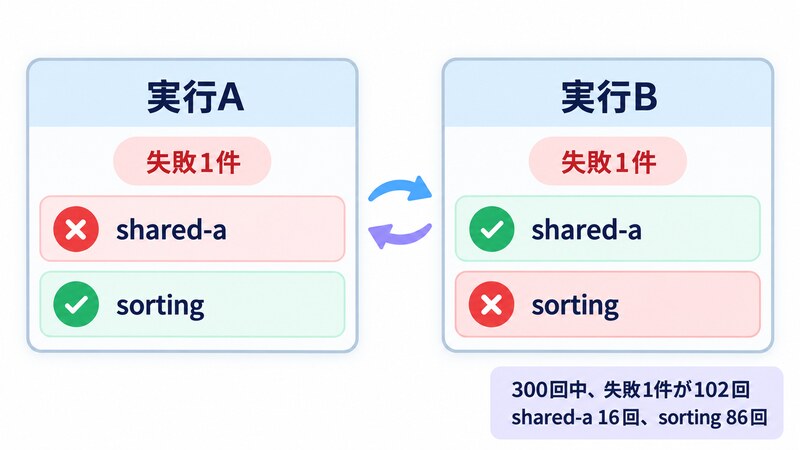
失敗が1件だった実行は102回あります。ところが、その中身を調べると、shared-a だけが落ちた実行が16回、sorting(時間のテスト)だけが落ちた実行が86回と割れていました。たとえば7回目は shared-a だけ、48回目は sorting だけが落ちています。どちらも「失敗1件」なのに、落ちたテストが違うのです。
失敗が1件以上あった実行どうしを比べると、失敗件数が同じ組は5451組あり、そのうち1422組は落ちたテストの名前が違いました。この数は、実行どうしを総当たりで数えた目安なので、割合の推定には使えません。それでも、件数ではなく、どれが落ちたかを見る理由としては十分です。
リトライだけで済ませる落とし穴
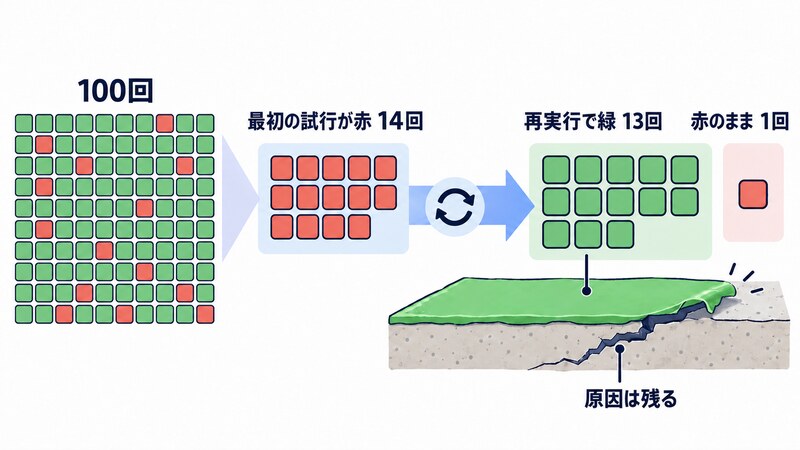
落ちるなら、失敗したときだけ再実行して、緑になるまで待てばよさそうです。実際、Google の記事も、自動で再実行することを緩和策の一つとして挙げています。テスト全体が赤なら最大3回まで試行する(再実行は最大2回)運用を100回試すと、最初の試行が赤だったのは14回でした。そのうち13回は再実行で緑になり、最終結果が赤のままだったのは1回だけです。
import { spawnSync } from 'node:child_process';

const files = ['shared-a.test.js', 'shared-b.test.js', 'timing.test.js'];
let firstAttemptRed = 0, finalRed = 0, retriedThenGreen = 0;
for (let s = 0; s < 100; s++) {
  let green = false, attempts = 0;
  while (!green && attempts < 3) {
    attempts++;
    const r = spawnSync('node', ['--test', ...files], { encoding: 'utf8', env: { ...process.env, LIMIT_MS: '100', ITER: '10' } });
    green = r.status === 0;
  }
  if (attempts > 1) firstAttemptRed++;
  if (!green) finalRed++;
  if (attempts > 1 && green) retriedThenGreen++;
}
console.log(JSON.stringify({ sessions: 100, firstAttemptRed, retriedThenGreen, finalRed }));
r.status は終了コードで、0が成功を意味します。結果は次のとおりです。
{"sessions":100,"firstAttemptRed":14,"retriedThenGreen":13,"finalRed":1}
赤だった14回のうち13回が、最終結果からは見えなくなりました。ところが、このテストには何も直っていません。問題はリトライそのものではなく、最初の失敗を記録せず、最後の緑だけを見てしまうことです。初回の失敗を数えておけば、この記事で見たような割合も追えます。
この実験のテストは、どれもフレークだけで、本物の不具合は含んでいません。そのため、本物の不具合も同じように隠れるかどうかは実測していません。ただ、Google の記事は、失敗を「フレークだ」と片付けたあとで、本物の不具合だったと分かることがあると述べています。再実行は失敗を減らしますが、フレークを無視する方向にも働きうる、という論理です。
まとめ
フレークとは、同じコードなのに結果が変わるテストで、その正体は、コード以外のものへの依存でした。実行順、共有資源、時間の3つは、小さな例で再現できます。
見つけるには、同じテストを何十回も回して、落ちる割合と、どれが落ちたかを見ます。割合は環境で変わるので、一度の数字ではなく回数を重ねて見ます。リトライは緩和策になりえますが、それだけで済ませず、初回の失敗を残しておきます。
直し方の方向は、原因ごとに次のようになります。
- 実行順: 各テストが、必要な状態を自分で用意する。(実測していない方向性です)
- 共有資源: テストごとに専用のパスを使う。実測では、並列のままで100回中0回でした。
--test-concurrency=1は競合を避ける暫定回避にとどまります。 - 時間: 上限に余裕を持たせる、または時刻や処理時間そのものに依存しない書き方にする。(実測していない方向性です)
次に CI が赤から緑に変わったら、「再実行して通った」で終わらせず、何に依存していたのかを一度だけ疑ってみてください。
参考にした一次情報
- Flaky Tests at Google and How We Mitigate Them(Google Testing Blog)(フレークの定義、原因、再実行の扱い)
- Test runner | Node.js v22 Documentation(テストファイルの別プロセス実行と
--test-concurrency)