
Unicode正規化のNFCとNFKCを入力・表示・保存で使い分ける
Unicode正規化は文字列の等価性を整えますが、アプリ固有の保存形式までは決めません
フォームに入力された二つの文字列が、画面ではどちらも「グループ」と表示されています。ところが、プログラムで比べると一致しないことがあります。先頭の「グ」が、片方は1個のコードポイント、もう片方は2個のコードポイントでできているからです。
コードポイントは、Unicodeが文字や記号に割り当てた番号のことです。画面に見える一文字と、その裏にある番号の数は、いつも一対一とは限りません。
こうした表現の違いを決まった形へそろえるのが、Unicode正規化です。ただし、正規化がしてくれるのは「そろえる」ところまでです。アプリがどんな形で表示し、どんな形で保存するかまでは決めてくれません。
正規化には、どこまでを同じ文字とみなすかによって、Unicodeが定めたいくつかの形式があります。NFCとNFKCはその中でよく使う二つの形式の名前で、頭のNFはNormalization Form(正規化形式)の略です。NFCは書き方が違うだけの同じ文字をそろえ、NFKCはそれに加えて、半角・全角のような見た目の違いまでそろえます。
では、それぞれに任せてよいのはどこまでで、どこから先をアプリ側で決めればよいのでしょうか。この「グループ」を半角カナで受け取り、画面では全角で見せ、保存では半角に戻す小さな例で確かめます。
目次
同じ「グ」が同じ文字列とは限りません
Unicodeでは、合成済みの「グ」をU+30B0という一つのコードポイントで表せます。一方、「ク」(U+30AF)の後ろに濁点の結合文字U+3099を並べても、画面では同じ「グ」に見えます。結合文字は、直前の文字にくっついて一文字として表示される文字です。
const precomposed = '\u30B0';
const decomposed = '\u30AF\u3099';

console.log(precomposed === decomposed); // false
console.log(precomposed.normalize('NFC') === decomposed.normalize('NFC')); // true
なぜ、見た目が同じなのに最初の比較はfalseになるのでしょうか。JavaScriptの===は、画面に描かれた形ではなく、文字列を作っている値そのものを比べるからです。
Node.js v20.19.6で中身を見ると、正規化前のコードポイント列は["U+30B0"]と["U+30AF", "U+3099"]でした。どちらもNFCで正規化すると["U+30B0"]になり、比較も一致しました。
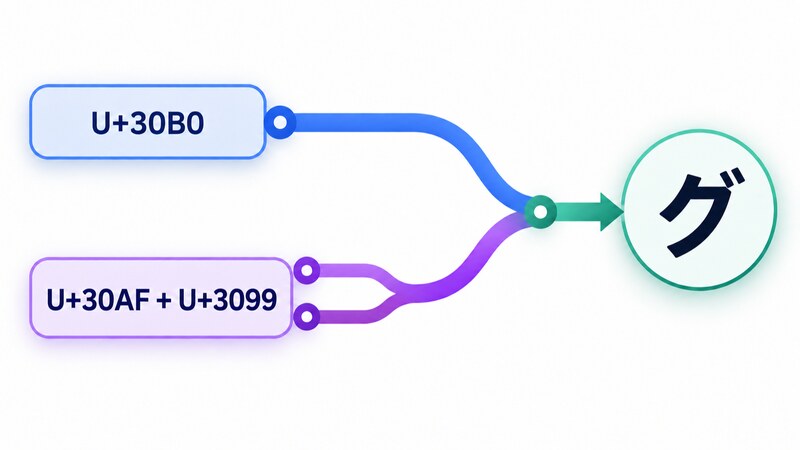
この二つのように、同じ文字を表していて、正しく表示されれば見た目も振る舞いも同じになる表現どうしを、Unicodeでは正準等価と呼びます。「書き方は違うけれど、中身は同じ文字」という関係です。
文字数にも同じずれが出ます。JavaScriptの文字列は16-bitの単位(UTF-16のコードユニット)が並んだもので、lengthはその個数を返します。今回の「グ」は、合成済みなら長さ1、結合文字を使った形なら長さ2でした。
つまり、見た目の文字数とlengthは一致するとは限りません。入力の文字数を制限するなら、正規化とは別に、コードユニット・コードポイント・利用者が一文字と感じる単位のどれで数えるかも決めておく必要があります。
NFC・NFD・NFKC・NFKDの地図
冒頭のNFCとNFKCを含め、Unicodeの正規化形式は4種類あります。名前が似ていて混乱しやすいのですが、NFの後ろの文字に注目すると整理できます。
K(compatibility、互換)が付くかどうか:付かない形式は正準等価だけをそろえます。付く形式は、半角・全角や丸数字のような互換等価の違いまでそろえます。- 最後が
DかCか:D(decomposition、分解)は分解した形で終わります。C(composition、合成)は分解したあと、できる範囲で合成し直します。
| 終わり方 | 正準等価だけそろえる | 互換等価までそろえる |
|---|---|---|
| 分解した形で終わる(D) | NFD | NFKD |
| 分解後、できる範囲で合成する(C) | NFC | NFKC |
分解と合成は、「グ」で考えると分かりやすいです。分解すると、「グ」は「ク」(U+30AF)と結合濁点(U+3099)の二つに分かれます。NFDはこの形で止まり、NFCはもう一度合成してU+30B0の「グ」に戻します。
合成は、どんな組み合わせでもできるわけではありません。合成済みの一文字が用意されていない組み合わせもあるので、NFCやNFKCの合成は「できる範囲で」になります。
互換等価は、正準等価より一段ゆるい「同じ」です。同じ文字を表してはいるものの、幅や装飾といった見た目の区別がある表現どうしを指します。半角のグと全角のグ、①と1がその例です。
NFCとNFKCの差は、実際の入力でどう現れるのでしょうか。Node.js v20.19.6(ICU 77.1、Unicode 16.0)で代表的な文字を試した結果が次の表です。ICUは、Node.jsが内部で使っている国際化ライブラリです。
| 入力 | NFC | NFKC | NFKCで畳まれた違い |
|---|---|---|---|
グ | グ | グ | 半角と全角 |
① | ① | 1 | 丸付きと丸なし |
A | A | A | 全角と半角 |
| 全角空白 | 全角空白 | 半角空白 | 空白の幅 |
NFCは、どの文字もそのまま残しました。一方、NFKCは半角カナだけでなく、丸数字、全角英字、全角空白の区別まで畳みました。ここでいう「畳む」は、区別をなくして一つの形にまとめることです。
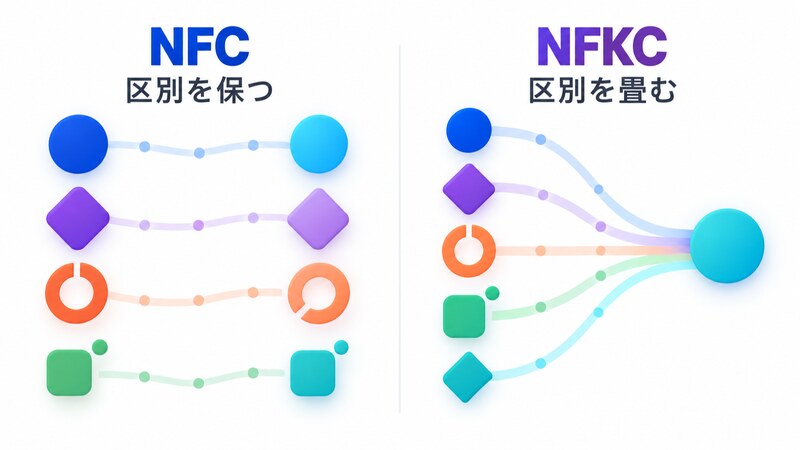
ここで「入力は全部NFKCにしておけば安全だ」と考えてよいのでしょうか。Unicode正規化を定めた付属文書(Unicode Standard Annex #15)は、NFKCとNFKDを文章へ無条件に使わないよう注意しています。互換上の違いが、文脈によっては意味を持つからです。
たとえば丸数字を普通の数字に変える処理は、検索で照合する値としては便利です。けれども、利用者が入力した表記をそのまま見せたい欄には向きません。NFKCを選ぶのは、そこでは幅や丸数字などの区別を捨ててよい、と決めることです。
JavaScriptのnormalizeが保証する範囲
JavaScriptでは、String.prototype.normalize()でUnicode正規化を使えます。引数を省略するとNFCになり、指定できるのはNFC、NFD、NFKC、NFKDの4つだけです。
console.log('A'.normalize() === 'A'.normalize('NFC')); // true

try {
  'A'.normalize('INVALID');
} catch (error) {
  console.log(error.name); // RangeError
}
同じNode.jsで試すと、省略時の結果はNFCと一致しました。それ以外の名前を渡すと、値が許される範囲の外にあるときの例外であるRangeErrorが投げられました。どちらも、JavaScriptの標準仕様であるECMAScriptに書かれているとおりの動きです。
ただし、normalize('NFKC')は「保存先の都合に合わせて半角へ変える関数」ではありません。保証されているのはNFKCという正規化形式への変換だけで、特定のAPIやファイル形式が求める独自の表記は対象外です。
入力・表示・保存は三つの契約です
冒頭の「グループ」に戻ります。「グ」の濁点に加えて、「プ」の半濁点も含む単語です。入力では半角カナのグループを受け付け、画面では全角のグループで見せ、保存先には半角カナで渡す、という仕様だとします。
入力にNFKCをかけると、表示用の値はグループになりました。ところが、その値をそのまま保存に回すと全角のままで、期待したグループにはなりません。
なぜNFKCをもう一度かけても、半角には戻らないのでしょうか。NFKCには戻り道がないからです。互換上の違いを畳んでから合成する変換で、畳んだ区別を元に戻す逆向きの変換は持っていません。
そこで、表示用の変換と保存用の変換を分けます。文字列が次の処理へ渡るこうした地点を、ここでは境界と呼びます。表示の境界ではNFKCをかけ、保存の境界では、全角の4文字を半角へ置き換える対応表を使いました。
const halfwidthStorage = {
  '\u30B0': '\uFF78\uFF9E',
  '\u30EB': '\uFF99',
  '\u30FC': '\uFF70',
  '\u30D7': '\uFF8C\uFF9F',
};

const toDisplay = (value) => value.normalize('NFKC');
const toStorage = (value) =>
  Array.from(toDisplay(value), (character) => {
    const converted = halfwidthStorage[character];
    if (converted === undefined) {
      return character;
    }
    return converted;
  }).join('');

console.log(toDisplay('\uFF78\uFF9E\uFF99\uFF70\uFF8C\uFF9F')); // グループ
console.log(toStorage('\uFF78\uFF9E\uFF99\uFF70\uFF8C\uFF9F')); // グループ
toDisplayはグループを、toStorageはグループを返しました。試しに保存用の変換を外し、表示用の値をそのまま保存するよう書き換えると、期待値との比較はfalseになりました。
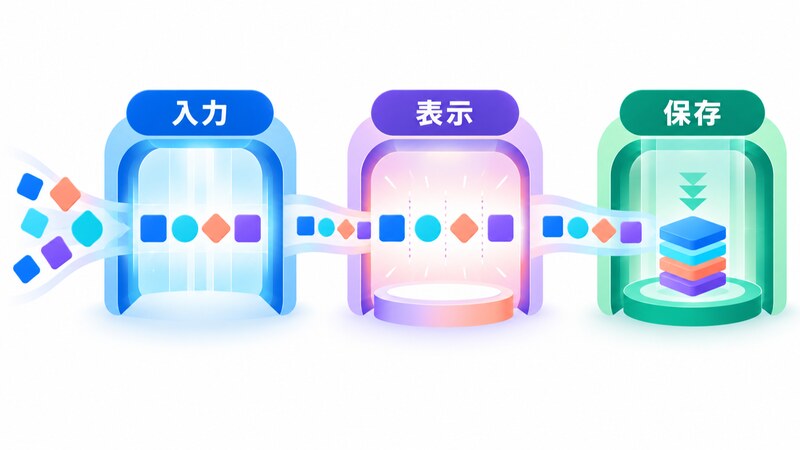
この対応表は「グループ」の4文字しか扱わない確認用の小さな例なので、実際のコードに持ち込みたいのは表そのものではありません。入力で受け付けるもの、画面で見せるもの、外部へ渡すものを、それぞれ別の契約として分けておく考え方です。ここでいう契約は、その場面で文字列が満たすべき取り決めのことです。
保存先がNFCの文字列をそのまま受け付けるなら、保存用の変換はNFCだけで足りるかもしれません。一方、別の文字集合や表記ルールを求める形式なら、正規化のあとに、その形式専用の変換がもう一段必要です。
利用者が入力した表記そのものに意味がある場合は、正規化前の原文と、比較や検索に使う正規化済みの値を分けて持つ手もあります。NFKCをかけた値だけを保存すると、元が「①」だったのか「1」だったのかは後から分かりません。原文を残すかどうかは、正規化する前に決めておく必要があります。
正規化は境界で行います
入力イベントのたびに正規化しておけば、それで安心でしょうか。そうとは限りません。入力中の表示と比較と保存では目的が違うので、境界ごとに必要な形を決めておくほうが、あとから追いかけやすくなります。
たとえば比較用の値を作る境界では、どの違いまで同じとみなすかを決めてから、NFCかNFKCを選びます。表示の境界では入力された表記を残すか整えるかを、保存の境界では保存先の契約にどう合わせるかを決めます。
見落としやすい境界がもう一つあります。文字列の連結です。正規化済みの文字列どうしをつないでも、つないだ結果が正規化済みになるとは限りません。
const left = '\u30AF'.normalize('NFC');
const right = '\u3099'.normalize('NFC');
const joined = left + right;

console.log(left === left.normalize('NFC')); // true
console.log(right === right.normalize('NFC')); // true
console.log(joined === joined.normalize('NFC')); // false
console.log(joined.normalize('NFC')); // グ
「ク」と結合濁点は、それぞれ単独ではNFCの形でした。ところが、つないだ文字列はNFCではなく、NFCをかけ直すと合成済みの「グ」(U+30B0)になりました。
部品がそろっていても、組み立てた結果までそろっているとは限らない、ということです。つないだ文字列にも決まった正規化形式を求めるなら、連結したあとの境界でもう一度正規化します。
テストは境界のつながりを見ます
変換関数ごとのテストが通っていれば、入力から保存まで安心でしょうか。関数がどれも正しくても、表示用の値を保存にそのままつないでしまえば、三つの契約は崩れます。
そこで、次の三つを一続きで確かめました。見ているのは、入力が保存値へどう届くかという通しの流れです。
- 2種類の「グ」は、そのままでは一致せず、NFCのあとでは一致します。
- 半角カナの入力は、NFKCのあとに全角で表示されます。
- 保存用の変換を通した値は、期待した半角の文字列になります。
さらに、保存用の変換を外した版も用意し、期待値との比較が失敗することを確かめました。正しい結果が出ることだけでなく、配線を間違えたときにテストがきちんと落ちることまで見ておくと、そのテストを安全網として信頼できます。
今回確かめたのは、Node.js v20.19.6(ICU 77.1、Unicode 16.0)とmacOS arm64の環境で、記事に出てくる代表的な文字だけです。Unicode全体での動き、日本語入力の変換中にブラウザが送るイベントの順番、データベース側での文字列比較や検索性能への影響は確かめていません。
迷ったときの設計チェック
Unicode正規化を組み込む前に、次の問いに答えておきましょう。選ぶ手がかりは形式の名前より、残したい違いと畳んでよい違いのほうです。
- 同じものとして比べたいのは、正準等価な表現だけですか。それとも半角・全角のような互換等価な表現も含めますか。
- 丸数字、文字幅、空白の幅といった区別を、比較や保存に使う値で畳んでも困りませんか。原文を別に残す必要はありませんか。
- 利用者に見せる値と、APIやファイルへ渡す値は同じ契約ですか。
- 文字列を連結したり一部を書き換えたりしたあとも、正規化済みである必要がありますか。
- 変換を一つ外したとき、境界のテストはきちんと失敗しますか。
NFCは、正準等価な表現をそろえつつ、互換上の違いは残します。NFKCはもっと広くそろえてくれますが、そのぶん意味のある見た目の違いまで畳んでしまうことがあります。
Unicode正規化が整えてくれるのは文字列の等価性までで、アプリが使う保存形式までは決めてくれません。 入力・表示・保存の契約を分け、境界ごとに何を残すかをテストしておくと、見た目では気づけない不一致を早めに捕まえられます。
参考にした一次情報
- Unicode Standard Annex #15: Unicode Normalization Forms(正準等価と互換等価、4種類の正規化形式、NFKCの注意、正規化済み文字列の連結を確認しました)
- ECMAScript Language Specification: String.prototype.normalize(JavaScriptで選べる形式、省略時のNFC、不正な形式名の
RangeErrorを確認しました) - ECMAScript Language Specification: The String Type(Stringの要素、UTF-16コードユニット、
lengthが数える単位を確認しました)