
Claude の文章透かし SynthID-Text は、どこに印を入れているのか
AI が書いた文章の透かしは、モデルが迷った場所にしか入らない
2026年8月2日以降に登場した Claude のモデルは、生成する文章に見えない透かし(文章の中に埋め込まれた、機械にだけ読み取れる印)を持つようになりました。Anthropic のサポート記事はこう書いています。
“Claude models launched on or after August 2, 2026 will support machine-readable marking at launch.”
対応するモデルは、発売と同時にこの機械可読な印を持つということです。ではその印は、どこにどうやって埋め込まれているのでしょうか。Anthropic 自身の説明はこうです。
“Nothing is added to the text and there are no hidden characters.”
文字は一切足されておらず、隠し文字も無い、とあります。文字を足さず、隠し文字も置かないのに、いったい何を変えているのでしょうか。
この透かしは、Anthropic が独自に発明したものではありません。公式の説明によれば、Google DeepMind が2024年に Nature 誌で発表した SynthID-Text 方式の一種を実装したものです。
“Claude’s text watermark is a version of the SynthID-Text approach published by Google DeepMind in a Nature paper in 2024.”
なお、これはテキストだけの話です。Claude が生成する画像やベクター画像には、まったく別の仕組みが使われます。
“When Claude generates a supported file type, such as a .svg, .png, or .jpg, it will attach signed provenance metadata. This metadata follows the Coalition for Content Provenance and Authenticity (C2PA) open standard.”
svg・png・jpg には C2PA という別の来歴証明の規格が使われ、この記事が扱う「文字を足さない透かし」とは別物です。導入の背景には規制もあります。Anthropic は EU AI Act への対応として、2026年7月に他の主要な AI 事業者とともに透明性に関する Code of Practice に署名したと説明しています。
“We’re implementing watermarking to comply with the EU AI Act.”
Anthropic の解説記事は、この疑問に答える具体例を1つ挙げています。「アイザック・ニュートンの最も有名な著作は」という書き出しの続きを考えてみてください。歴史をある程度知っていれば、次に来る単語はほぼ一つに決まります。
『プリンキピア・マテマティカ』の「マテマティカ」です。この記事のあいだ、何度もこの一文へ立ち返ります。透かしが入るのも、入らないのも、この「マテマティカ」のような場所で起きるからです。
目次
次の語を選ぶ乱数を、鍵付きにすり替える
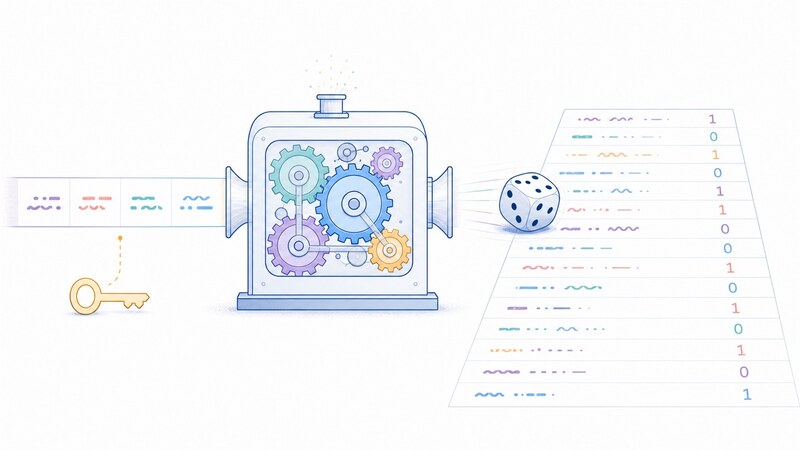
Claude のようなモデルは、文章を一文字ずつではなく「トークン」という単位で組み立てます。単語よりも短いことが多い、モデル内部の最小の言葉の単位です。次にどのトークンを置くかを決めるとき、モデルは「語彙」——選べるトークンの一覧——のすべてに確率を割り振ります。これが次トークン分布です。
文章を1つ生成するたびに、モデルはこの分布からくじを引くように1つのトークンを選びます。これがサンプリングです。くじの引き方を平らにしたり尖らせたりするつまみが温度で、上げるほど低い確率のトークンも選ばれやすくなります。ふつうのくじ引きには疑似乱数——見た目はランダムだが、実は決まった手順で計算される数——を使います。
透かしは、このくじの引き方自体は変えません。くじを引くのに使う乱数の出どころだけを、鍵を持った疑似乱数にすり替えます。その乱数の種は、直前に並んだいくつかのトークン(この並びを n-gram と呼びます)と鍵をハッシュ関数にかけて作ります。Nature 論文はこう書いています。
“For the random seed generator, in our experiments we use the existing sliding-window method, where the random seed is a hash of the most recent H tokens (x_{t−H}, …, x_{t−1}; we use H = 4) along with the watermarking key.”
実験では直前4トークン(H=4)を種として使ったとあります。この種から、語彙の一つひとつのトークンに「0」か「1」の点数(g値)を割り振る関数が作られます。この関数はレイヤーと呼ばれる層の数だけ独立に用意されていて、論文の実験で使われた層の数は30です。g関数と n-gram の合計で透かしを埋め込むという発想自体は、2022年に Scott Aaronson がブログで示したものが出発点になっています。
論文の「勝ち抜き戦」と、実装の1行の for 文
論文はこの点数の使い方を「トーナメント(勝ち抜き戦)サンプリング」と呼びます。候補のトークンをペアにして、点数の高いほうを勝ち抜かせる、という説明です。
“We randomly divide these candidates into M/2 pairs, and, in the first tournament layer, in each pair the token with the higher score under g_1(⋅, r_t) is selected.”
“For our experiments, we generally use m = 30 layers unless otherwise stated”
層を増やしても検出のしやすさは際限なく上がるわけではない、とも書かれています。
“detectability does not increase indefinitely with the number of layers”
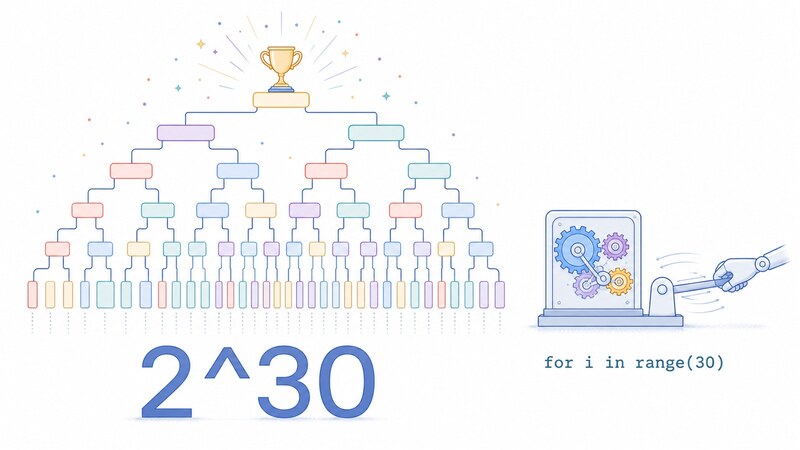
では、実際のコードは2の30乗個ものトークン候補を本当に用意して、対戦させているのでしょうか。Google DeepMind が公開している参照実装のコードを読むと、そうはなっていません(このコードは読んだだけで、実行はしていません)。
probs = torch.softmax(scores, dim=1)

for i in range(depth):
    g_values_at_depth = g_values[:, :, i]
    g_mass_at_depth = (g_values_at_depth * probs).sum(axis=1, keepdims=True)
    probs = probs * (1 + g_values_at_depth - g_mass_at_depth)
候補をサンプルして対戦させる代わりに、確率そのものを30回(depth回)押し引きしているだけです。1回の押し引きでやっているのは、g値が1のトークンの確率を少し持ち上げ、0のトークンを少し下げること。持ち上げ幅と下げ幅は、その時点の確率で重みづけした g の平均(コード中の g_mass_at_depth)に対して決まります。論文が「30層のトーナメント」と呼んでいるものの正体は、このループが30回まわるという、それだけのことでした。
この更新が本当に確率の配り直しでしかないのかは、実際に計算して確かめられます。語彙512個・30層で2000本の鍵を試したところ、更新後の確率の合計と1との差は最大でも6.661e-16、確率が負になることもありませんでした(最小値は−4.141e-34で、これは浮動小数点の丸め由来です)。鍵の全パターンを数え上げて平均すると、更新前の分布と機械精度でぴったり一致します。語彙6・レイヤー2の4096パターンすべてを列挙した場合で、差は最大8.882e-16でした。
Anthropic が「Nothing is added to the text」と言っているのは、この意味で文字どおりです。透かしはトークンを足したり引いたりせず、確率という手持ちの資源を配り直しているだけです。
対戦のペアの数によって、この配り直しには2つの流儀があります。1試合あたりの候補がちょうど2つなら、論文はこれを「歪みなし」と呼びます。
“When Tournament sampling is configured with exactly two ‘competitors’ for each match in the tournament, then Tournament sampling is single-token non-distortionary.”
参照実装でもこの分かれ目は1行の if 文です。
if self._num_leaves == 2:
    updated_scores = update_scores(scores_top_k, g_values)
else:
    updated_scores = update_scores_distortionary(
        scores_top_k, g_values, self._num_leaves
    )
num_leaves の既定値は2、つまり既定では歪みなしの流儀が使われます。この記事でこのあとに出てくる実測は、すべてこの歪みなし側のものです。歪みあり(num_leaves が3以上)の挙動は、コードを読んだだけで実測はしていません。
選ぶ余地が無ければ、透かしは1ビットも動かない
ここから先の実測は、Claude 本体ではなく、公開されている0.5B程度の小さなモデル(Qwen/Qwen2.5-0.5B-Instruct)に、Hugging Face の transformers に入っている実装(バージョン5.15.0)を適用して測ったものです。Claude の透かしそのものを測ったわけではなく、Anthropic が実際に使っている鍵の本数や層の数も公開されていません。
もし次のトークンが最初から1つに決まっていたら、この更新はどうなるでしょうか。確率がある1つのトークン x に完全に集中している(pₓが1でそれ以外が0)とき、その時点の確率で重みづけした g の平均は、ちょうど x の g 値と一致します。ほかのトークンの確率がすべて0だからです。すると更新式は p ← p×(1+g−g) = p×1 となり、何も変わりません。
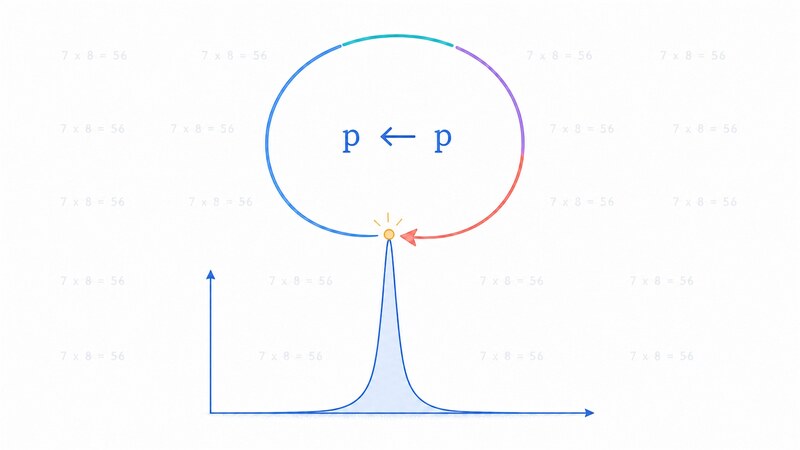
実際に測っても、この通りになります。ここから何度も出てくるスコアというのは、選ばれたトークンのg値を全部の層と全部の位置で平均した数値のことです。透かしが乗っていなければ0.5あたりに集まり、透かしが乗るほど0.5から上へ離れていきます。エントロピー(選択肢がどれだけ割れているかを表す数値で、1つに決まっていれば0)がちょうど0の分布で20000回試したところ、透かしなしのスコアと透かしありのスコアはどちらも0.50162で、差はぴったり+0.00000でした。温度を上げてエントロピーを1.5507ビットまで広げると差は+0.05102、4.5754ビットまで広げると+0.15361まで開きます。
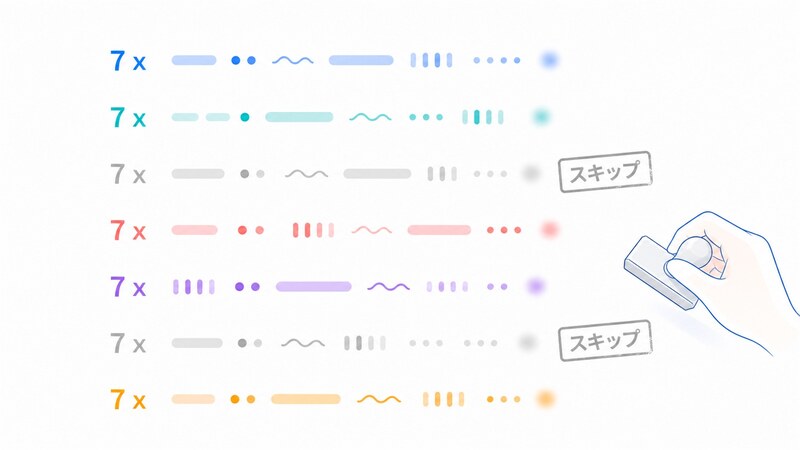
実際の文章でも同じことが起きます。「7 x 1 = 7」から「7 x 20」まで、7の段の九九を1行ずつ書かせたところ、透かしを当てたときとそうでないときで、スコアはどちらも0.50289、ばらつきはどちらも0.00000でした。5本ずつ生成した文章は、透かしのあるなしにかかわらず、すべて同じ196トークンでした。透かしを当てても、出てくる文章が1文字も変わらなかったということです。
答えが1つに決まる場所では透かしが働かないのに対して、Claude が翻訳した文章には透かしが入ります。Anthropic はこう説明しています。
“Yes. A translation produced by Claude carries a watermark, because in this case every word is chosen by Claude.”
原文の意味は1つに決まっていても、それを目的の言語のどの単語で表すかはモデルが選んでいるから、という理屈です。手直しについても同じ理屈が当てはまります。
“Light editing probably won’t remove the watermark completely; a complete rewrite where every word is replaced will.”
軽い手直しでは透かしは残り、単語を全部書き換えるような全面的な書き直しでは消える、ということです。手を入れた分だけモデルが選び直す場所が増える、と考えるとここまでの説明とつながります。
「ほとんど1つ」は「ほんの少ない」ではない
では、選択肢がほとんど1つに決まっている——たとえば99.99%の確率で同じトークンが選ばれる——場所では、透かしはほんの少ししか働かないのでしょうか。測ってみると、そうはなりませんでした。最大確率が99.99%(残りの確率は0.0001)の分布で、透かしを当てたときに確率が動く量は、残り確率の約128倍にまで増幅されていました。最大確率が完全に100%のときは5000本の鍵すべてでビット単位まで一致してまったく動かなかったのに、0.0001だけ残っている場合とではまるで結果が違います。
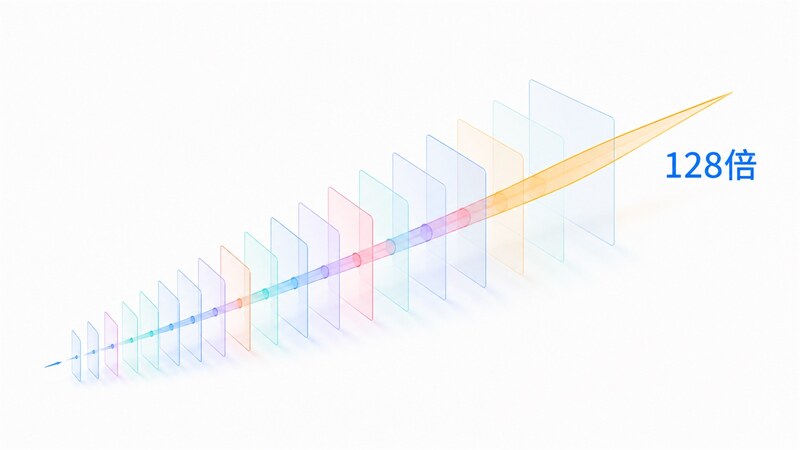
原因は層の数の多さです。1つの層あたりの倍率は最大で2倍ですが、これが30層積み重なるので、最大で2の30乗倍まで低い確率のトークンを持ち上げられます。確率の合計は1のまま保たれるので、持ち上がった分だけ、ほかのトークンの確率が下がります。「選択肢がゼロなら透かしもゼロ」は厳密に正しいのですが、「ほとんど1つに決まっている」は「ほんの少ししか透かせない」を意味しません。わずかに残った選択肢のほうへ、透かしはむしろ強く寄りかかります。
だから、コードや事実の羅列では透かしが薄くなる
Anthropic は、透かしが薄くなる場面をあらかじめ挙げています。
“Watermarking is sparser on factual passages where there are fewer choices that can be made without decreasing the accuracy of the text.”
“code—which in very many cases has to be exact—has generally less watermarking than some other forms of text.”
実際に3種類の文章を5本ずつ生成して測ると、この説明どおりの傾向が出ました。空が青く見える理由を説明させた長い文章では、透かしなしのスコア0.50026に対して透かしありは0.53416で、透かしなしのばらつき(0.00617)の5.5倍ぶん離れています。ところが7の段の九九を並べた文章では、前の節で見たとおり、透かしのあるなしでスコアがまったく同じでした。コードを書かせた場合も、透かしなし0.50262に対して透かしあり0.50035で、上がってはいません。
選択肢の少なさだけが理由なのでしょうか。実は理由はもう一つあります。参照実装には、直前の n-gram の並びがすでに一度使われていたら、その位置には透かしを当てないという仕組みがあります。
# 5. Check if the current watermarking context was previously used, if
# yes skip watermarking.
...
updated_watermarked_scores = torch.where(
    is_repeated_context,
    input=scores_top_k,
    other=updated_scores,
)
この仕組みが要る理由も、実測すると分かります。同じ分布を全ての位置で使い回して測ったところ、文章を10トークンから400トークンまで伸ばしても、透かしなしのスコアのばらつきは0.035前後で止まりました。理屈のうえでは長くするほどばらつきは小さくなるはずです。原因は、同じトークンが繰り返され、直前4トークンの並びが使い回されていたことでした。文脈が同じなら乱数の種も同じで、同じ g 値を何度も足しているだけなので、いくら長くしても独立した証拠は増えません。
位置ごとに違う分布を用意し、この仕組みを入れて測り直すと、ばらつきは理屈どおり縮みました。400トークンでの実測の標準偏差(sd)は0.00452で、理屈上の値 0.5/√(30×400)≒0.00456 とほぼ一致します。実際の文章でこの仕組みがどれだけ働いているかも測りました。
透かしを当てた文章のうち、繰り返し文脈のせいで対象から外れた位置の割合は、長い説明では0.6%だったのに対し、7の段の九九では21.9%、コードでは29.6%でした。def や return、インデントの並びが同じパターンで何度も出るからです。コードや事実の羅列が薄くなるのは、選択肢が少ないことに加えて、同じ並びが繰り返されて位置そのものが透かしの対象から外れる、という2つの理由が重なっているためです。
検出は何が分かって、何が分からないのか
採点する側に何が要るのでしょうか。Nature 論文はこう書いています。
“A scoring function only requires access to the tokenized text, the watermarking key k and the random seed generator f_r; no access to the LLM is required.”
文章とトークナイザ(文章をトークンへ切り分ける仕組み)、そして鍵さえあれば採点でき、モデル本体は要らないということです。採点の結果は0.5からの距離として読みます。透かしなしの文章のスコアは平均0.5に集まり、そのばらつきは層の数 m と使った位置の数 T から 0.5/√(mT) で決まります。位置ごとに分布を変えて400トークンで測ると、実測のばらつきは0.00452で、理屈上の値0.00456とほぼ一致しました。
文章を10トークンから400トークンへ40倍に伸ばすと、透かしありとなしの隔たりは5.3標準偏差から34.2標準偏差まで、6.45倍に広がりました。√40≒6.32とほぼ一致する伸び方です。ここで使ったのは合成した分布なので、実際の文章にはエントロピーの低い位置がもっと混ざり、隔たりはこれより小さくなるはずです。
では、鍵を知らない人が同じ文章を採点したら、どう見えるのでしょうか。鍵を1本だけ違うものに差し替えて採点しても、スコアはほとんど動きませんでした(0.53416から0.53174へ)。層は30層あり、それぞれが独立した証拠を持つので、鍵1本を失っても失われる証拠は30分の1だけです。鍵を全部差し替えて採点すると、スコアは0.503から0.510程度まで下がり、透かしなしの文章と見分けがつかなくなりました。
それでも、この採点で分かることには限りがあります。
“Using our key, one can only answer the question ‘What is the likelihood this was partly written by Claude?'”
人が書いたことを確認する手段にはならず、別の AI が書いた文章かどうかを見分けることもできない、と Anthropic は説明しています。低い偽陽性率(誤って透かしありと判定してしまう割合)なら、それで十分安心できるのでしょうか。OpenAI は2024年に自社の透かしを開発しながら、公開を見送った理由の一つにこう書いています。
“While text watermarking has a low false positive rate, applying it to large volumes of text would lead to a large number of total false positives.”
偽陽性率そのものが低くても、世の中に出回る文章全体に占める AI 生成の割合(基準率)が低ければ、大量に採点した結果としての誤判定の絶対数は積み上がっていきます。OpenAI は非ネイティブ話者への不利益も懸念として挙げていました。
“it could stigmatize use of AI as a useful writing tool for non-native English speakers.”
透かしの強さを決めるつまみ
自分でこの方式を試すなら、何を確認すればよいでしょうか。実装によって挙動を左右するつまみは、だいたい次の4つに絞られます。
| つまみ | 役割 | 参考値 |
|---|---|---|
| ngram_len(直前何トークンを種にするか) | 大きいほど繰り返しに強くなる一方、検出に必要な文脈も長くなる | Hugging Face の推奨は5、最低でも2 |
| 鍵の本数(=層の数) | 多いほど証拠が積み重なるが、検出のしやすさは頭打ちになる | Hugging Face の推奨は20〜30本、論文の実験は30層 |
| num_leaves | 2なら歪みなし、3以上なら歪みあり(参照実装の既定は2) | この記事の実測はすべて歪みなし側 |
| 繰り返し文脈をどこまで覚えておくか | 同じ n-gram が再び出た位置を透かしの対象から外す仕組みの効き方を左右する | 具体的な既定値は実装によって異なる |
ここに挙げた数値は、Hugging Face の実装が推奨している値や、論文の実験で使われた値であって、Claude が実際に使っている設定ではありません。Anthropic は鍵の本数も層の数も、歪みあり・なしのどちらを使っているかも公開していません。
まとめ
「アイザック・ニュートンの最も有名な著作は」の続きに「マテマティカ」が来ることに、透かしはほとんど手出しできません。選ぶ余地がそこに無いからです。透かしが乗るのは、モデルがどちらへ転んでもおかしくない場所——次の語を決めかねている場所だけです。
この記事で測った数字は、Claude ではなく小さな公開モデルで、Hugging Face の実装を動かして得たものです。Anthropic が実際にどんな設定を使っているかは公開されていません。それでも、確率が一点に集中すれば更新が自分自身に戻ってくるという代数の結果は、モデルの大きさに関係なく成り立ちます。
次に AI が書いた長い説明文と、事実を並べただけの一覧を読み比べる機会があったら、どちらに「選ぶ余地」が多かったかを考えてみてください。透かしの薄い場所がどこか、見えてくるはずです。
参考にした一次情報
- Anthropic: How Claude’s text watermark works(導入・仕組み・限界・検出の各節で使用)
- Anthropic サポート記事: How Claude marks AI-generated content(導入で C2PA との違いを示す箇所、検出 API が未公開である点で使用)
- Nature論文: Dathathri et al., Nature 634:818–823 (2024)(仕組み・トーナメント・検出・品質の節で使用)
- 参照実装 google-deepmind/synthid-text(コードの節で引用。読んだだけで実行はしていない旨を本文に明記)
- Hugging Face: Introducing SynthID Text(実測に使った実装の出典、つまみの節の推奨値)
- EU AI Act 第50条(導入の規制的背景)
- 欧州委員会: 透明性 Code of Practice の発表(導入の規制的背景)
- OpenAI: Understanding the source of what we see and hear online(検出の節、誤検知の絶対数について)
- Scott Aaronson氏のブログ (2022)(仕組みの節、g関数の系譜について)