
Gemma 4 26B vs Nemotron 3.5 Bolt 74B を「1依頼の秒数」で比べる
自前 GPU の LLM は、tok/s ではなく 1 依頼の秒数と正解数で比べる
自前の GPU マシンで動かす LLM を選ぶとき、最初に目に入る数字はたいてい tok/s(1 秒あたりに生成するトークン数)です。数字が大きいほど速そうに見えるので、つい「速いほうを採用」と決めたくなります。ところが、アプリから見て本当に知りたいのは「1 回頼んでから答えが返ってくるまで何秒か」と「その答えが合っているか」のはずです。
この記事では、NVIDIA DGX Spark(GB10)1 台に llama-server を 2 つ並べ、Gemma 4 26B-A4B と Nemotron 3.5 Bolt 74B-A9B(以下 Gemma と Bolt)を動かして測りました。DGX Spark は CPU と GPU が同じ 128GB のメモリを使うマシンで、llama-server は、ローカルで LLM を動かす llama.cpp に付いている OpenAI 互換の HTTP サーバです。
どちらのモデルも MoE(Mixture of Experts)という構造で、入力に応じて一部の専門家(重みのまとまり)だけを選んで計算します。Gemma は総パラメータ 25.2B のうち動くのが 3.8B で、名前の A4B は「active parameters(動く重み)が約 4B」という意味です(モデルカード、つまり Hugging Face のモデル説明ページの表では 3.8B)。Bolt は総 74B のうち動くのが 9B です。
ただし、2 つの条件は揃っていません。Gemma は Q8_0、Bolt は 2-bit の量子化(重みの数値を少ないビット数で持ち、メモリと計算を減らす方式)で、llama.cpp のビルドも起動フラグも違います(ビルドは Gemma が b1-63d93d1、Bolt が b1-3ed7284)。揃えたのは、依頼の中身、プロンプト、temperature 0 だけです。
評価に使ったデータはすべて架空で、ネットショップのヘルプ 160 項目から問い合わせに合う項目を選ぶ「分類」と、ホテルの予約フォーム 24 件への「入力」です。1 台・1 回ずつの計測なので、どちらのモデルが優れているかを決める記事ではありません。数値はすべて「この条件では」と読んでください。
目次
1 依頼の秒数は、読み込みと生成の足し算
LLM の推論は、大きく 2 段に分かれます。最初にプロンプト全体を読み込む段階(prefill)があり、その後に答えを 1 トークンずつ書いていく段階(decode)が続きます。トークンとは、モデルが文字列を切り分ける単位のことで、単語や文字の断片だと思ってください。
NVIDIA の技術ブログは、2 つの LLM の tok/s が似ていてもトークナイザが違えば同等とは限らない、と書いています。トークナイザとは、文字列をトークンへ切り分ける部品です。
そもそも tok/s は、2 段のうち生成の段階の速さしか表していません。
では、秒数は何で決まるのでしょうか。llama-server は応答に timings という項目を付けて、読み込みと生成のトークン数と時間を分けて返してくれます。これを使って、まず最小の計測コードを書いてみます。
// 1 依頼の秒数と、llama-server が返す timings の内訳を並べて出す
const BASE = process.argv[2]; // 例: http://127.0.0.1:8080
const body = {
  messages: [{ role: "user", content: "東京から大阪へ行く方法を 3 つ、1 行ずつ挙げてください。" }],
  max_tokens: 200,
  temperature: 0,
  // 推論(thinking)を既定で行うモデルがある。比べるときは明示的に切る(または両方で入れる)
  // chat_template_kwargs は llama-server 独自のパラメータ(OpenAI の API には無い)
  chat_template_kwargs: { enable_thinking: false },
};

for (let i = 1; i <= 3; i++) {
  const t0 = performance.now();
  const res = await fetch(`${BASE}/v1/chat/completions`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify(body),
  });
  const json = await res.json();
  const seconds = (performance.now() - t0) / 1000;
  const t = json.timings; // llama-server 独自の項目(OpenAI の API には無い)
  console.log(
    `${i}回目: 合計 ${seconds.toFixed(2)} 秒` +
      ` | 読み込み ${t.prompt_n} トークン(キャッシュ ${t.cache_n})${(t.prompt_ms / 1000).toFixed(2)} 秒` +
      ` | 生成 ${t.predicted_n} トークン ${(t.predicted_ms / 1000).toFixed(2)} 秒(${t.predicted_per_second.toFixed(1)} tok/s)`,
  );
}
コードは Node.js v22 で確認しました。トップレベルの await を使うので、ファイル名は measure.mjs のように .mjs にして、node measure.mjs http://127.0.0.1:8080 のように実行します。
timings の cache_n は、前回の依頼と共通で再利用できた読み込み済みトークン数です。これを 2 つのサーバに向けて実行した結果が次のとおりです(上のコメント 1 行を足す前の版で取りました。足した版でもトークン数は同じで、秒数もほぼ同じでした)。== ... の見出し行は、どちらの出力かを示すために手で付けました。それ以外は出力そのままです。
== Gemma 4 26B-A4B
1回目: 合計 1.19 秒 | 読み込み 30 トークン(キャッシュ 0)0.10 秒 | 生成 54 トークン 1.05 秒(51.2 tok/s)
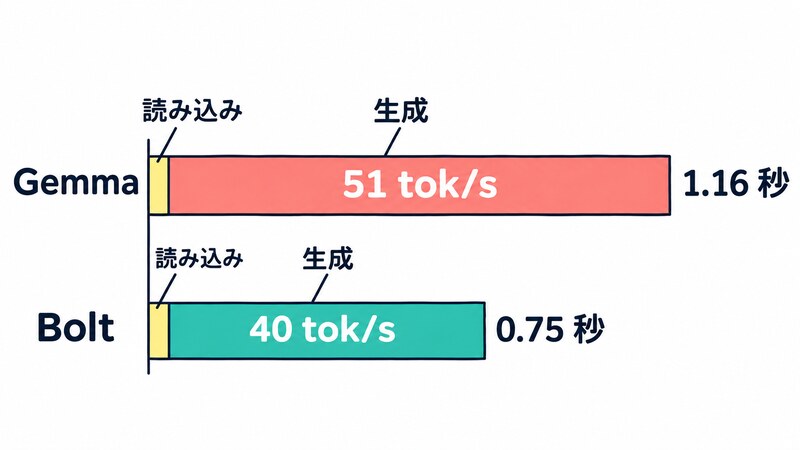
2回目: 合計 1.16 秒 | 読み込み 30 トークン(キャッシュ 0)0.09 秒 | 生成 54 トークン 1.05 秒(51.5 tok/s)
3回目: 合計 1.16 秒 | 読み込み 30 トークン(キャッシュ 0)0.09 秒 | 生成 54 トークン 1.05 秒(51.5 tok/s)
== Nemotron 3.5 Bolt 74B-A9B
1回目: 合計 0.79 秒 | 読み込み 4 トークン(キャッシュ 32)0.11 秒 | 生成 26 トークン 0.63 秒(39.7 tok/s)
2回目: 合計 0.75 秒 | 読み込み 4 トークン(キャッシュ 32)0.09 秒 | 生成 26 トークン 0.62 秒(40.2 tok/s)
3回目: 合計 0.75 秒 | 読み込み 4 トークン(キャッシュ 32)0.10 秒 | 生成 26 トークン 0.62 秒(40.0 tok/s)
生成速度は Gemma が約 51 tok/s、Bolt が約 40 tok/s で、tok/s だけ見れば Gemma の圧勝です。ところが 1 依頼の秒数は、Gemma が 1.16 秒前後、Bolt が 0.75 秒前後で、Bolt のほうが先に終わりました。キャッシュが Gemma は 0、Bolt は 32 と違いますが、読み込みはどちらも 0.1 秒前後で、秒数の差の原因ではありません。
理由は出力のトークン数で、Bolt は 26 トークンで答え終え、Gemma は 54 トークン書いています。Bolt の答えは 3 行の短い箇条書きで、新幹線・高速バス・飛行機を挙げただけでした。Gemma の答えは記録していないので、中身の比較まではしていません。
落とし穴: thinking を切らないと、本文が空になる
上のコードの chat_template_kwargs: { enable_thinking: false } は、実は飾りではありません。thinking とは、答える前に頭の中で考える推論の段階のことで、Bolt は何も指定しないと考え始めます。この行を渡さずに同じ依頼を送ると、次のようになりました。
{} | finish length | out 200 | reasoning chars 614 | content: ""
{"chat_template_kwargs":{"enable_thinking":false}} | finish stop | out 26 | reasoning chars 0 | content: "新幹線で移動する。\n高速バスで移動する。\n飛行機で移動する。"
1 行目が指定なしです。上限の max_tokens 200 を思考で使い切って(finish length)、本文が空のまま返ってきました。エラーにもならないので、気づかないまま「このモデルは何も答えない」と判断してしまいそうです。
一方、Gemma 側のサーバは起動時に thinking を切ってありました。比べるときは、両方で明示的に切るか、両方で入れましょう。以降の thinking の話は Bolt だけを測ったものです。
同じ文でも、トークンの数はモデルごとに違う
トークナイザが違うと、同じ文字列でもトークン数が変わります。llama-server の /tokenize で数えてみると、次のようになりました。
| 文章 | 文字数 | Gemma | Bolt |
|---|---|---|---|
| 分類の system プロンプト(日本語・ヘルプ 160 項目) | 4,815 | 3,012 | 4,221 |
| 予約の system プロンプト(日本語) | 739 | 370 | 450 |
1 行の JSON(JSON.stringify そのまま) | 107 | 38 | 43 |
字下げした JSON(JSON.stringify(x, null, 2)) | 175 | 81 | 69 |
| 英文 “The quick brown fox jumps over the lazy dog.” | 44 | 10 | 10 |
日本語の分類プロンプトでは、Bolt のほうが 4 割ほど(4,221 対 3,012)多くなりました。一方、英文は両方とも 10 トークンで同じです。この差は、今回の 2 モデルと、この文章での話にすぎません。トークナイザ一般の性質としては言えませんが、日本語を扱うアプリでは確かめる価値があります。
JSON の結果は少し意外です。1 行に詰めると Bolt のほうが多く、字下げすると Bolt のほうが少なくなりました。空白や改行の切り方の違いが効いているのかもしれませんが、確かめてはいません。少なくとも「どちらが JSON に強いか」という単純な話ではなさそうです。
この差は、出力の形にも効いてきます。予約フォームへの入力を JSON スキーマ(出力できる形を文法で縛り、スキーマに合う JSON しか出させない仕組み。llama.cpp では文法制約と呼びます)付きで頼むと、中身は同じでも字下げの付け方がモデルごとに違いました。
Gemma(169 トークン)
{
  "intent": "fill",
  "fill": [
    {
      "key": "guestName",
      "value": "山田太郎"
    },
    ...(5 件)
  ],
  "notOnForm": []
}

Bolt(116 トークン)
{
  "intent": "fill",
  "fill": [
    {"key": "guestName", "value": "山田太郎"},
    ...(5 件)
  ],
  "notOnForm": []
}
Gemma は 1 項目を 4 行に広げ、Bolt は 1 行に詰めています。情報量は同じなのに、生成トークン数は 169 対 116 です。スキーマを付けずに頼んだときは、どちらのモデルも頼んだ形(配列)ではなく辞書の形で返し、Gemma は Markdown のコードブロックで囲みました。囲まれるとアプリがそのまま JSON として読めないので、トークン数以前の問題でもあります。
速いほうが、遅く終わることもある
では、生成速度の高いモデルは、常に先に終わるのでしょうか。逐次に 3 回流した中央値で、分類と予約を比べてみました。表の「合計」は 1 依頼にかかった秒数、「出力」は生成したトークン数です。
| 依頼 | Gemma 合計 / 出力 tok / 生成 tok/s | Bolt 合計 / 出力 tok / 生成 tok/s |
|---|---|---|
| 分類・キャッシュ無し | 2.65 s / 43 / 43.2(読み込み 3,044 tok を 1.49 s) | 4.22 s / 26 / 36.6(読み込み 4,253 tok を 3.44 s) |
| 分類・キャッシュあり | 1.04 s / 43 / 43.4 | 0.81 s / 26 / 36.4 |
| 予約・JSON スキーマあり | 4.12 s / 169 / 48.1 | 3.18 s / 116 / 38.4 |
| 予約・スキーマ無し | 2.12 s / 98 / 49.0 | 2.34 s / 86 / 38.5 |
生成速度は一貫して Gemma のほうが高く、43〜49 対 36〜39 tok/s です。それでも、キャッシュありの分類とスキーマありの予約は Bolt が先に終わりました。分類の答えは Gemma が候補を 3 つ、Bolt が 2 つ返したので、中身が違うぶん短く済んでいます。ここでも「短く答えるモデルは、tok/s が低くても先に終わる」が起きています。
ところが、キャッシュ無しの分類では順位が逆転します。読み込みが Gemma は 3,044 トークンを 1.49 秒、Bolt は 4,253 トークンを 3.44 秒かかっており、生成の差を読み込みの遅さが食いつぶしました。スキーマ無しの予約でも Gemma が先に終わるので、勝ち負けは依頼の種類と設定で入れ替わります。
もうひとつ気づいたことがあります。Gemma のスキーマあり予約では、往復 4.12 秒に対して timings の読み込み+生成が 3.61 秒で、約 0.5 秒が timings の外にありました。原因は切り分けていません。ただ、アプリが体感するのは往復の秒数なので、timings だけでなく自分で測った往復時間も並べておくのが安全です。
長い文脈と、同時に流したときの溢れ
プロンプトが長くなると、読み込みも生成も遅くなります。文脈とは、モデルが一度に扱うプロンプトと答えのトークン全体のことです。出力を 256 トークンに固定し、キャッシュ無しで文脈の長さだけを変えて測ると、生成速度の落ち方がモデルで違いました。
| 文脈の長さ | Gemma 生成 tok/s | Bolt 生成 tok/s |
|---|---|---|
| 約 1,000 トークン | 48.3〜48.7 | 39.2〜39.3 |
| 約 31,000 トークン | 37.8〜37.9 | 37.6 |
Gemma は 48.5 から 37.9 tok/s へと約 2 割落ち、Bolt は 39.3 から 37.6 tok/s へとほとんど落ちません。31k ではほぼ並びます。読み込みの速さは Gemma が約 1,770〜2,110 tok/s、Bolt が約 980〜1,310 tok/s でした。ただし、これは同じ「トークン数」で比べた結果です。同じ日本語の文章なら、Bolt のほうが 4 割多いトークンになることを思い出してください。
もっと分かりやすい差が出るのは、同時に複数の依頼を流したときです。llama-server は、同時に処理する依頼の枠(スロット)を持っています。今回は両方とも 4 スロットで、KV キャッシュ(過去のトークンの計算結果を取っておく領域)を 4 本で共有する構成でした。Bolt の起動フラグは --parallel 4 --kv-unified で、文脈の長さは -c で指定します。
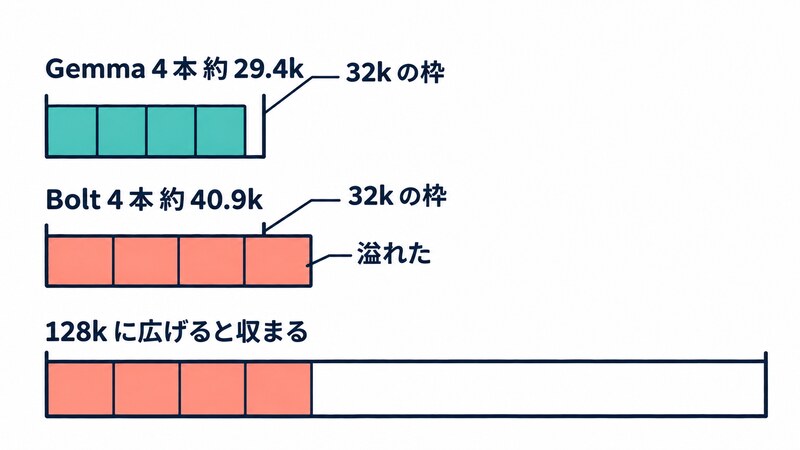
同じ 11,747 文字のプロンプトを 4 本同時に 30 秒流し続けると、トークン数はモデルごとに違います。Gemma は 7,338 トークン、Bolt は 10,216 トークンです。4 本ぶんの合計は、Gemma が約 29.4k、Bolt が約 40.9k になります。
== gemma(-c 32768・スロット 4・KV 共有)
prompt chars=11747 tokens=7338
concurrency | ok | failed | per min | median s | p90 s | errors
4 | 6 | 0 | 8.9 | 26.20 | 34.06 |
== bolt(-c 32768・スロット 4・KV 共有)
prompt chars=11747 tokens=10216
concurrency | ok | failed | per min | median s | p90 s | errors
4 | 0 | 8 | 0.0 | 0.00 | 0.00 | HTTP 500: {"error":{"code":500,"message":"Context size has been exceeded.","type":"server_error"}}
== bolt(-c 131072)
prompt chars=11747 tokens=10216
4 | 4 | 0 | 6.2 | 38.85 | 38.90 |
同じ -c 32768 でも、Gemma は全件成功し、Bolt は 8 件すべてが Context size has been exceeded で失敗しました。文脈を 128k(-c 131072)に広げると、Bolt も 4 件成功しています。「同じ文量なのに、トークンの数え方が違うせいで、同時実行の上限が変わる」わけです。
溢れるのは 1 本ごとの上限なのか、それとも合計なのかを確かめるため、もうひとつ測りました。9,586 トークンの依頼を Gemma に流すと、1 本なら通ります。4 本同時(合計約 38.3k)にすると、全部が落ちました。
prompt chars=15362 tokens=9586
concurrency | ok | failed | per min | median s | p90 s | errors
1 | 8 | 0 | 14.4 | 3.99 | 5.49 |
4 | 0 | 8 | 0.0 | 0.00 | 0.00 | HTTP 500: {"error":{"code":500,"message":"Context size has been exceeded.","type":"server_error"}}
サーバの /slots で各スロットの文脈長を見ると、4 つとも -c の値そのまま(Gemma は 32768)で、等分されていませんでした。つまり、この構成(4 スロット・KV 共有)では、文脈は全依頼の合計で使い切られます。しかも、はみ出した 1 本だけでなく、同時に流した依頼がすべて失敗しました。KV の共有を切った構成は測っていないので、そちらの上限は言えません。
メモリのほうはどうでしょうか。nvidia-smi で見たプロセス別のメモリ使用量は、Gemma の 32k が 28,803 MiB、Bolt の 32k が 21,876 MiB、Bolt の 128k が 22,741 MiB でした。Bolt は文脈を 4 倍にしても約 865 MiB しか増えず、Gemma(32k)より小さいままです。これはプロセス単位の表示で、重みと KV キャッシュなどの内訳までは分けていません。
投機的デコードは、内容によって効きかたが変わる
秒数を縮める手段として、投機的デコードがあります。小さな下書きモデルが先の数トークンを予想し、本体のモデルがまとめて検算する方式で、Leviathan らの論文は出力を変えずに速くできると述べています。今回は Bolt に DFlash(約 1GB の下書きモデルを使う投機的デコードの実装)を付けて、まず 1 依頼ずつ測りました。
| 依頼 | 下書き無し | DFlash |
|---|---|---|
| 予約・スキーマあり(116 トークン) | 3.18 s・38.4 tok/s | 1.29 s・113.6 tok/s |
| 分類・キャッシュあり(26 トークン) | 0.81 s・36.4 tok/s | 0.57 s・58.7 tok/s |
| 分類・キャッシュ無し | 4.22 s(読み込み 3.44 s) | 4.56 s(読み込み 4.03 s) |
形の決まった短い JSON は約 3 倍に伸びる一方で、キャッシュ無しの分類は読み込みが 3.44 秒から 4.03 秒に遅くなり、合計も遅くなりました。
自由な文章を 256 トークン生成させる実測では、DFlash で 1,000 トークンの文脈なら 70.4 tok/s、31,000 トークンなら 57.4 tok/s で、下書き無しとの比はおおむね 1.8 倍から 1.5 倍です。つまり、効き目は何を書かせるかで変わります。採択率(下書きのうち採用された割合)までは取っていません。
同時実行にも注意が要ります。予約を同時に流したときの件数は、DFlash が同時 1 の 52.4 件/分から同時 4 の 61.1 件/分へとあまり伸びませんでした。それでも同時 4 では、DFlash が 61.1 件/分、下書き無しが 35.7 件/分、Gemma が 43.4 件/分で、DFlash が最も多いです。
出力は変わらないはずですが、予約 24 件で下書き無しと DFlash を比べると、バイト単位で一致したのは 23 件でした。残る 1 件(h14)も JSON としては同じで、違うのは空白だけです。正解数はどちらも 22/24 でした。h14 のような「h」付きの番号は、予約 24 件のうちの何件目かを表す件の ID です。
temperature 0 でも、同じ答えとは限らない
ここで、同時実行の測定にひとつ不審な点がありました。予約だけを繰り返した同時 1 の、下書き無し側の中央値が 4.62 秒と、逐次測定の 3.18 秒より 1.5 秒遅かったのです。timings を見ると、生成が 116 トークンではなく 179 トークンになっていました。
Bolt を再起動して予約だけを繰り返すと、毎回この答えが返ります。大人の人数が空になっています。
{
  "intent": "fill",
  "fill": [
    {"key": "guestName", "value": "山田太郎"},
    {"key": "checkIn", "value": "2026-12-24"},
    {"key": "checkOut", "value": "2026-12-26"},
    {"key": "adults", "value": ""},
    {"key": "children", "value": ""},
    {"key": "roomType", "value": "twin"},
    {"key": "breakfast", "value": ""},
    {"key": "arrivalTime", "value": ""},
    {"key": "phone", "value": ""},
    {"key": "note", "value": ""}
  ],
  "notOnForm": []
}
temperature は 0 で、プロンプトも同じです。最初はキャッシュの当たり方(読み込みの分け方)が原因だと疑って、キャッシュ無し・全部キャッシュ・途中まで再利用の 3 通りで試しました。
A fresh 1 prompt_n=586 cache_n=0 out=179 adults="" keys=10
A fresh 2 prompt_n=586 cache_n=0 out=179 adults="" keys=10
A fresh 3 prompt_n=586 cache_n=0 out=179 adults="" keys=10
B primed 1 prompt_n=4 cache_n=582 out=179 adults="" keys=10
B primed 2 prompt_n=4 cache_n=582 out=179 adults="" keys=10
B primed 3 prompt_n=4 cache_n=582 out=179 adults="" keys=10
C split 1 prompt_n=49 cache_n=537 out=179 adults="" keys=10
C split 2 prompt_n=49 cache_n=537 out=179 adults="" keys=10
C split 3 prompt_n=49 cache_n=537 out=179 adults="" keys=10
どの読み込み方でも答えは同じ 179 トークンでした。ところが、同じサーバのまま分類の依頼をはさむ順で流すと、予約は 116 トークンの答えに戻ります。この出力は、読み込みと生成のトークン数と秒数だけを並べたものです。
classify | 0.81 | 4 / 4249 / 0.09 | 26 / 36.6 / 0.68
booking | 3.15 | 4 / 582 / 0.09 | 116 / 38.6 / 2.98
classify | 0.81 | 4 / 4249 / 0.10 | 26 / 36.6 / 0.68
booking | 3.19 | 4 / 582 / 0.09 | 116 / 38.5 / 2.98
読み込みの分け方では再現せず、直前にサーバが何を処理したかで答えが変わる、というところまでしか分かっていません。内部の原因は切り分けていません。llama.cpp の server README には、前回の依頼と共通する先頭部分の読み込み結果を再利用する cache_prompt というオプション(既定は有効)の説明として、バッチサイズ(一度にまとめて計算するトークン数)が違うとロジット(次のトークンの候補ごとのスコア)がビット単位で同じになるとは限らず、有効にすると非決定的な結果になりうる、という趣旨の記述があります。今回の現象とこの説明が同じ原因かは確認していません。観測したのは Bolt(2-bit)だけで、Gemma で起きるかも調べていません。
教訓は単純です。比べるときは、依頼の順番を変えて複数回流してください。1 回の結果だけを見て「このモデルはこの依頼が苦手」と決めると、サーバの状態のせいかもしれません。
同じプロンプトで比べても、公平とは限らない
ここからは精度の話です。予約フォームへの入力は、JSON スキーマで形を強制したうえで、Gemma と Bolt に同じプロンプトを渡しました。依頼文から読み取れた欄だけを fill に入れ、フォームにない項目を依頼されたときだけ別の欄に書かせる、という作りです。プロンプトは v1 から v4 まで版を重ねていて、最初の版(v1)の結果は、24 件中の正解が Gemma 3 件、Bolt 18 件でした。
| プロンプト | Gemma | Bolt |
|---|---|---|
| v1(最初の版) | 3/24 | 18/24 |
| v1(誤りだった正解 1 件を直した後) | 4/24 | 19/24 |
| v2(「依頼に出てこなかった欄の名前は書かない」を足す) | 5/24 | 19/24 |
v3(v2 のまま、JSON のキー名だけ missing → notOnForm) | 22/24 | 22/24 |
v1 だけを見れば「Bolt の圧勝」ですが、v3 では同点です。Gemma の v1・v2 の誤りは、ほとんどが missing というキーに「値を入れなかった欄の名前」を並べたものでした(行頭の h01 などは件の ID です)。
h01 NG 4.4s out=195    missing:["children","breakfast","arrivalTime","phone","note"]
h02 NG 3.8s out=171 missing:["guestName","adults","children","arrivalTime","phone"]missing(足りない)という名前から、モデルは「依頼に書かれていなかった欄」を入れる場所だと読み取ったようです。指示の文を足しても(v2)直らず、キー名を notOnForm(フォームにない項目)に変えたら 5 件から 22 件に変わりました。モデルが悪いのではなく、評価に使ったプロンプトがどちらかに不利だったのです。
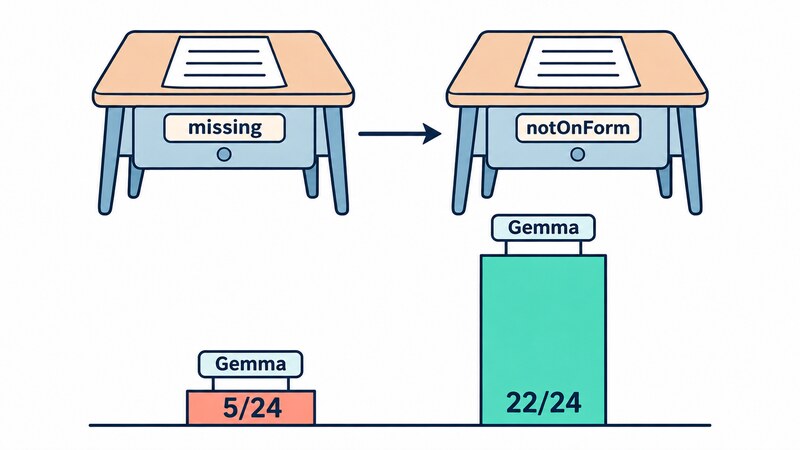
そのため、モデルを替える前に、評価に使うプロンプトを疑ってください。同じプロンプトを両方に渡したからといって、公平に比べたことにはなりません。
例を足す対策にも副作用がありました。v3 に「答えの形の例」を 1 行足した版が v4 です。
答えの形の例: {"intent": "fill", "fill": [{"key": "adults", "value": "2"}], "notOnForm": []}この例の値 "2" が、人数の書かれていない依頼(h19 の「シングルを2部屋」)に入ってしまいました。実測の出力では、両モデルとも extra:adults=2 と出ています。
h19 NG 1.1s out=49   extra:adults=2 missing:[]
h19 NG 1.4s out=46   extra:adults=2 missing:[]
1 行目が Gemma、2 行目が Bolt です。さらに、Gemma は例に合わせて 1 件 1 行の詰めた書き方になり、出力が 169 トークンから 107 トークンに減りました。
その結果、v3 では Bolt が 1 秒近く速かった予約が、v4 では Gemma 2.84 秒・Bolt 2.82 秒と並びました。プロンプトの例は、答えの値だけでなく書き方(秒数)まで動かします。
thinking は「精度と時間の交換」
ここまでの測定は、thinking を切って行ったものです(冒頭の落とし穴の確認を除きます)。では、thinking を入れれば精度は上がるのでしょうか。Bolt で、考える量の上限(予算)を 512 と 2,048 トークンに変えて試しました。上限なしの設定は、出力上限 8,192 で測っています。
予算は、リクエストに chat_template_kwargs: { enable_thinking: true } と thinking_budget_tokens: 予算 を入れて指定します。上限なしにするときは、後者を送りません。まず、ヘルプ 160 項目から合う項目を選ぶ分類 40 件の結果です。表の p50 / p90 は、出力トークン数を小さい順に並べたときの 50 % / 90 % 位置の値です。
| 構成 | 1 位正解 | 上位 3 | 中央値 | 出力トークン p50 / p90 / 最大 |
|---|---|---|---|---|
| Gemma thinking なし | 40/40 | 40/40 | 0.73 s | — |
| Bolt thinking なし | 37/40 | 40/40 | 0.75 s | 19 / 32 / 33 |
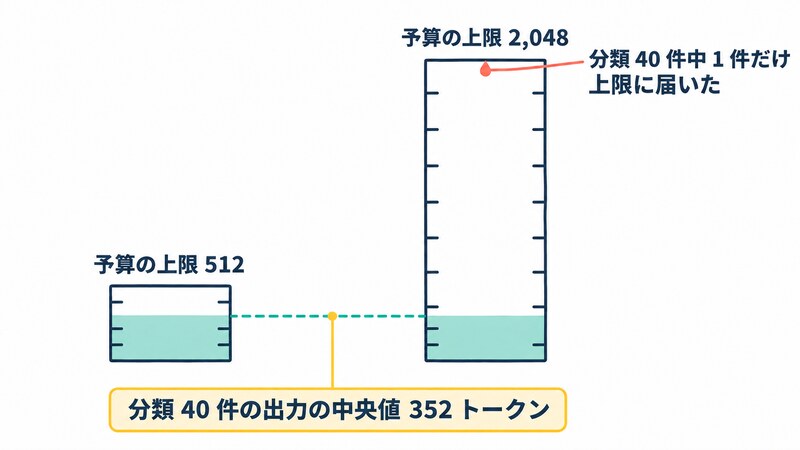
| Bolt 予算 512 | 37/40 | 38/40 | 9.42 s | 352 / 532 / 546 |
| Bolt 予算 2,048 | 38/40 | 38/40 | 9.38 s | 352 / 657 / 2,075 |
thinking を入れても 1 位正解は 37 件から 37〜38 件に動いただけで、上位 3 件の正解は 40 件から 38 件に減りました。thinking なしでは 2 位に残っていた正解を、thinking ありでは候補を 1 つに絞って落とした例があります(c05 などは分類の件の ID です)。
各行の読み方は、件の ID、判定(1 は 1 位が正解、3 は 1 位は外れたが上位 3 に正解あり、x は上位 3 にも無し)、秒数、返した候補の項目、gold= が正解の項目です。
c05 3 0.9s T015,T006 gold=T006     ← thinking なし(2 位に正解)
c05 x 14.0s T015 gold=T006         ← 予算 512(候補 1 つ・不正解)
c26 3 0.9s T060,T009 gold=T009
c26 x 12.3s T060 gold=T009
中央値は 0.75 秒から 9.4 秒へと、約 12 倍に伸びました。注目したいのは、予算が目標ではなく上限だという点です。出力トークンの中央値は予算 512 でも 2,048 でも 352 です。出力が予算以上になった件は、予算 512 では 40 件中 9 件、予算 2,048 では 1 件だけでした(思考と答えの合計で数えたので、多めに出ている可能性があります)。「予算を増やせば、その分だけ考える」わけではなく、易しい依頼なら途中で考えるのをやめます。
予約フォームの 24 件でも結果は同じ向きでした。v3 のプロンプトでは、thinking を入れると正解が 22 件から 18 件(予算 512)、20 件(予算 2,048、上限なし)に下がっています。原因を探るため、値が空になった h03 の 1 件だけを送り直して、思考の末尾を見ました。
--- reasoning (last 1200 chars) ---
...
Final JSON:
{
  "intent": "fill",
  "fill": {
    "adults": 2,
    "children": 1,
    "roomType": "double",
    "arrivalTime": "19:00"
  },
  "notOnForm": {}
}
...
I think that's it.
--- content ---
{
  "intent": "fill",
  "fill": [
    { "key": "adults", "value": "" },
    { "key": "children", "value": "" },
    { "key": "roomType", "value": "" },
    { "key": "arrivalTime", "value": "" }
  ],
  "notOnForm": []
}思考の中では、値を正しく読み取って辞書の形("adults": 2)で答えを組み立てていました。ところが文法制約は「キーと値の組の配列」を強制するので、本文では値が空になっています。答えの形の例を足した v4 で直ったので、他の件も同じ原因の可能性が高いと考えています。
答えの形の例を 1 行足した v4 では、同じ設定で結果が変わります。
| 構成 | v3 正解 | v3 中央値 | v4 正解 | v4 中央値 | 出力トークン p50 / 最大(v4) |
|---|---|---|---|---|---|
| thinking なし | 22/24 | 1.81 s | 21/24 | 1.67 s | 56 / 106 |
| 予算 512 | 18/24 | 14.74 s | 23/24 | 13.72 s | 541 / 619 |
| 予算 2,048 | 20/24 | 21.98 s | 24/24 | 14.89 s | 577 / 2,085 |
v4 で予算 2,048 なら 24/24 になりましたが、中央値は約 15 秒です。thinking なしの 1.7 秒から、8〜9 倍の時間を払って 21 件から 24 件に上げた計算になります。
thinking は精度と時間の交換であり、プロンプトが悪いままでは、時間を払っても精度が上がらないどころか下がることもあります。
なお、ここで使ったのはどちらも thinking なしでほぼ解ける易しい依頼です。難しい依頼で thinking が効くかは、このデータでは言えません。Gemma の thinking ありは測っていません。
自分の依頼で、秒数と正解数を一緒に測る
ここまでの話を、tok/s で比べるときの誤解と並べてまとめます。
- トークナイザが違うので、同じ文でもトークン数は違います。日本語の分類プロンプトでは 4,221 対 3,012 でした。
- 出力の形(JSON の字下げ、コードブロックの囲み、辞書か配列か)でも、生成トークン数が変わります。
- 共有の文脈はトークン数で使い切られるので、同じ
-cでも一方だけ溢れることがあります。 - 投機的デコードは内容によって効きかたが変わり、キャッシュ無しの読み込みは遅くなりました。
- temperature 0 でも、サーバの直前の状態で答えが変わりえます。
- thinking は精度と時間の交換で、予算は上限にすぎません。
tok/s は、この足し算のうち生成の一部の速さしか見ていません。自分のアプリが送るプロンプトと、受け取りたい出力の形で、1 依頼の秒数と正解数を一緒に測りましょう。最初の一歩は、この記事の前半で載せた十数行のコードを、自分の依頼に差し替えて実行することです。秒数が揃ったら、次はプロンプトの順番を変えて複数回流し、答えが安定しているかを確かめてください。
参考にした一次情報
- Mastering LLM Techniques: Inference Optimization(NVIDIA Technical Blog)(prefill と decode の 2 段、トークナイザが違えば tok/s が似ていても同等とは限らないこと)
- llama.cpp tools/server/README.md(
timingsの項目、cache_promptとバッチサイズによる非決定性の記述) - Fast Inference from Transformers via Speculative Decoding(Leviathan et al.)(投機的デコードが出力を変えずに速くできること)
- google/gemma-4-26B-A4B-it(Hugging Face のモデルカード)(MoE であること、総 25.2B・動く 3.8B、A4B の「A」の意味)
- nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF(Hugging Face のモデルカード)(MoE であること、総 74B・動く 9B)
- NVIDIA DGX Spark(製品ページ)(GB10、128GB の統合メモリ)