
一覧 API のページングで、total だけでは LIMIT の上限で切れたことに気づけない理由
続きがあるかどうかは件数では分からない。分かるのは、上限より1件多く取りに行ったときだけ
注文の一覧を返す API を作っているとします。検索条件に一致した注文を配列で返し、画面には「全 3500 件」のように総件数も出したいところです。多くの人がまず書くのは、次のような実装ではないでしょうか。
const MAX_LIMIT = 1000;

function listOrders(db, requestedLimit) {
  const limit = Math.min(requestedLimit, MAX_LIMIT);
  const items = db.prepare(
    "SELECT id FROM orders WHERE status = 'open' ORDER BY id LIMIT ?").all(limit);
  return { total: items.length, items };
}
サーバー側には、1回のリクエストで返す件数の上限(ここでは 1000 件)を設けてあります。無制限に返すとレスポンスが重くなりすぎるので、これ自体は珍しくない設計です。実装したその日にテストを書いて動かせば、件数はぴったり合いますし、エラーも出ません。
ところが、この実装には見落としがあります。status = 'open' の注文が本当は 3500 件あっても、画面には「全 1000 件」と表示されてしまうのです。件数を絞り込んだわけでも、バグで行を落としたわけでもありません。それでも、実際にある件数と画面の表示は一致しなくなります。どこで話がねじれたのでしょうか。
上限までしか見えていないのに、「これで全部」と言ってしまう一覧
目次
「上限で切れた」ときと「本当に全部届いた」ときが、同じレスポンスになる
さきほどの実装の total は items.length、つまりサーバーが返した配列の長さです。母集団(条件に一致する行の総数)を数えているわけではありません。上限より少ない件数しか無ければ問題は起きませんが、上限を超えている場合は話が変わります。
実際に、データの行数だけを変えて試してみました。status = 'open' の注文が 1000 件しかない場合と、3500 件ある場合とで、同じ実装に limit=5000(上限より大きい値)を要求してみます。
for (const n of [1000, 3500]) {
  const res = listOrders(makeDb(n), 5000);
  console.log(`実データ ${n} 件 / limit=5000 で要求 ->`,
    JSON.stringify({ total: res.total, itemsLength: res.items.length,
      lastId: res.items.at(-1).id }));
}
実データ 1000 件 / limit=5000 で要求 -> {"total":1000,"itemsLength":1000,"lastId":1000}
実データ 3500 件 / limit=5000 で要求 -> {"total":1000,"itemsLength":1000,"lastId":1000}2つのレスポンスは、total も items の長さも末尾の ID も、バイト単位で同じです。呼び出し側からは、このどちらのケースが起きているのか区別できません。エラーもログも残らないまま、切り捨てが起きた側の 2500 件が静かに見えなくなっています。
念のため補足すると、要求された limit を上限へ丸めること自体は問題ではありません。無制限にレスポンスを重くしないための、よくある設計です(この点は後の節で改めて触れます)。問題は、丸めた事実を total が一切教えてくれないことのほうです。
総件数の数え方には、少なくとも4通りある
「配列の長さを数える」以外にも、total の作り方はいくつか考えられます。SQL 側で数える方法も含めて、実際に4通り並べて比べてみました。母集団は 5000 件中 status = 'open' が 3500 件、上限は 1000 件という条件です。
-- (a) 返した配列の長さ(JS 側)
SELECT id FROM orders WHERE status = 'open' ORDER BY id LIMIT 1000

-- (b) LIMIT した結果を、もう一度数える
SELECT count(*) FROM (
  SELECT id FROM orders WHERE status = 'open' ORDER BY id LIMIT 1000
)

-- (c) 窓関数 COUNT(*) OVER () と LIMIT を同じ SELECT に書く
SELECT id, count(*) OVER () AS total
FROM orders WHERE status = 'open' ORDER BY id LIMIT 1000

-- (d) 別クエリで数える
SELECT count(*) FROM orders WHERE status = 'open'
(a) items.length = 1000
(b) count(*) of LIMITed subquery = 1000
(c) count(*) OVER () with LIMIT = 3500 (rows returned: 1000)
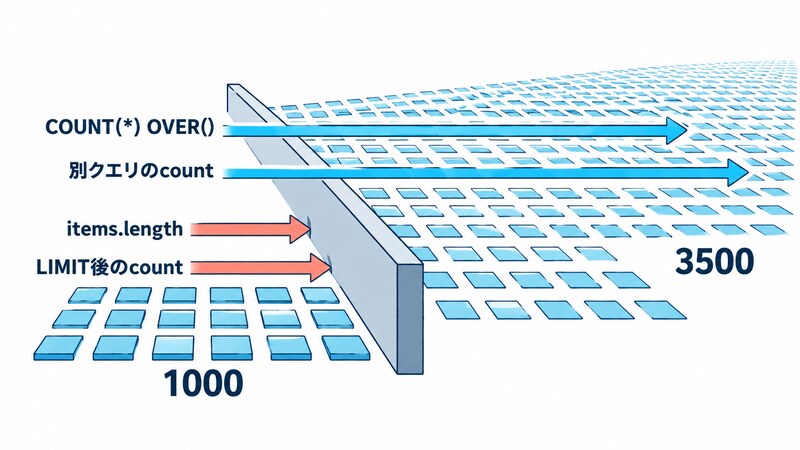
(d) separate count(*) query = 3500(a) と (b) は、どちらも「上限で切った後」の結果を数えているので、答えは上限と同じ 1000 になります。名前は違っても中身は同じ罠です。対して (c) と (d) は、条件に一致する母集団そのものを数えているので、正しく 3500 を返しています。
ここで気になるのは (c) の COUNT(*) OVER () です。LIMIT 1000 と同じ SELECT 文に書いてあるのに、なぜ上限より先に数えられるのでしょうか。OVER (...) は、集計する範囲(窓)を指定する書き方で、窓関数(ウィンドウ関数)と呼ばれます。括弧の中に PARTITION BY(集計をグループごとに分ける指定)を書けば行をグループ分けできますが、ここでは何も指定していないので、条件に一致した行全体を1つの窓として、その行数を数えます。
PostgreSQL の公式ドキュメントは、窓関数を WHERE や GROUP BY に書けない理由として、次のように説明しています。
Window functions are permitted only in the SELECT list and the ORDER BY clause of the query. They are forbidden elsewhere, such as in GROUP BY, HAVING and WHERE clauses. This is because they logically execute after the processing of those clauses.
つまり窓関数は WHERE で絞り込んだ後に評価されます。SELECT 文の処理順を定めた公式ドキュメントでも、出力行の計算(窓関数を含む SELECT リストの評価)は ORDER BY より前、LIMIT/OFFSET はさらにその後段に置かれています。
If the ORDER BY clause is specified, the returned rows are sorted in the specified order. … If the LIMIT (or FETCH FIRST) or OFFSET clause is specified, the SELECT statement only returns a subset of the result rows.
この処理順があるからこそ、COUNT(*) OVER () は「LIMIT で切り捨てられる前」の件数を、切り捨てられた行と一緒に数えられます。1回のクエリで、母集団の件数と、上限で切った一覧を同時に手に入れられるわけです。都合が良さそうに見えますが、この方式にも別の癖があります。次の節で見ていきましょう。
見抜き方と直し方を比べる
切り捨てを見抜くには、どうすればいいでしょうか。ここまでで候補は出そろいました。別クエリで母集団を数える方法、COUNT(*) OVER () で1回にまとめる方法、そして総件数そのものを諦めて「続きがあるか」だけを返す方法です。それぞれ試して、トレードオフを比べてみます。
別クエリで数える — 答えは「数えた瞬間」のもの
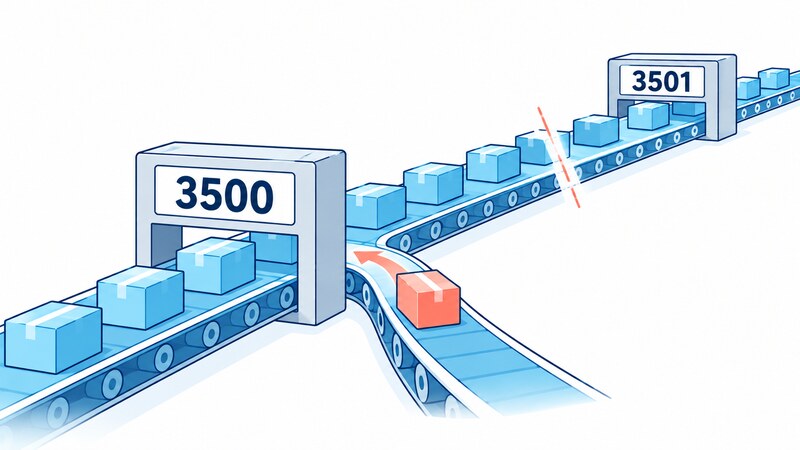
もっとも素朴な直し方は、total を別クエリの count(*) に差し替えることです。ただし、この方式には見落としやすい弱点があります。数えた瞬間から一覧を取り終えるまでの間に、行が増減すると値がずれるのです。
試しに、先に count(*) で 3500 件を数えた直後、他の誰かが1件登録し、そのあとページを送りながら全件を取り切ってみました。
const total = db.prepare("SELECT count(*) AS c FROM orders WHERE status = 'open'").get().c;
// 数えた直後、一覧を取る前に別の利用者が1件登録した
db.prepare("INSERT INTO orders(status) VALUES ('open')").run();
// ページサイズ 1000 で全ページを辿る(コードは省略)
total(先に数えた値)= 3500, 全ページを辿って実際に取れた件数 = 3501数えた値は 3500 のままなのに、実際にページを送って取れる件数は 3501 になりました。別クエリの count(*) は嘘をついているわけではなく、「数えた瞬間の値」を正確に返しているだけです。ページ遷移はリクエストをまたぐので、その間の増減までは面倒を見てくれません。
COUNT(*) OVER () — 1回で済むが、行が0件だと道連れで消える
COUNT(*) OVER () は総件数を行に相乗りさせる方式なので、返す行が1行も無いと、総件数も一緒に消えるという癖があります。OFFSET が範囲外になったときに実際どうなるか、試してみました。
SELECT id, count(*) OVER () AS total
FROM orders WHERE status = 'open' ORDER BY id LIMIT 1000 OFFSET :offset
OFFSET 3000 -> rows 500, total = 3500
OFFSET 3500 -> rows 0, total = (行が無いので取れない)
OFFSET 4000 -> rows 0, total = (行が無いので取れない)OFFSET 3000 では、残り 500 件と一緒に総件数 3500 も返ってきます。ところが OFFSET が母集団の件数を超えた瞬間、返る行自体が0件になり、total を乗せる場所そのものが無くなってしまいます。最後のページの、そのまた次を要求されたときに total をどう扱うかは、呼び出し側で別途決めておく必要があります。
もう1つ、コストの面でも意外な結果が出ました。「1回のクエリで済むなら COUNT(*) OVER () のほうが得」と予想して、100万行(索引あり)で速度を比べてみたのです。
LIMIT 1001(limit + 1)            中央値 0.49 ms
count(*) OVER () + LIMIT 1000    中央値 774.70 ms
別クエリ count(*) 中央値 66.74 ms予想は外れました。COUNT(*) OVER () は、別クエリの count(*) よりも1桁遅かったのです(2回の計測で約7〜12倍)。実行計画(データベースがそのクエリを実際にどう処理するかの手順書で、SQLite では EXPLAIN QUERY PLAN を付けて実行すると見られます)を見ると、理由がわかります。
count(*) OVER () + LIMIT 1000: CO-ROUTINE (subquery-2) / SEARCH orders USING COVERING INDEX idx_orders_status_id (status=?) / SCAN (subquery-2) / USE TEMP B-TREE FOR ORDER BY
別クエリ count(*): SEARCH orders USING COVERING INDEX idx_orders_status_id (status=?)窓関数版は、条件に一致する行をいったんサブクエリとして丸ごと組み立ててから、ORDER BY のために一時的な B-tree で並べ直しています。別クエリの count(*) は索引を数えるだけで、行の組み立ても並べ替えも発生しません。「1回で済む」というクエリの本数の少なさは、必ずしも軽さを意味しないわけです。
ここは SQLite 3.47.0(Node.js v22.12.0 の組み込み SQLite)・100万行・索引ありという1つの環境での実測にすぎず、絶対値は実行のたびに揺れます(2回計測して 443〜775ms の幅がありました)。それでも、総件数を取る2つの方法のうちでは別クエリの count(*) のほうが軽く、COUNT(*) OVER () が最も重いという順序は、2回とも変わりませんでした。なお、いちばん速かった LIMIT 1001 は総件数を数えていません。これが次に紹介するやり方です。「1クエリにまとめれば速いはず」という思い込みだけで選ばず、自分の環境で実行計画を見て確かめる価値はありそうです。
limit + 1 件取ってみる — 「あと何件か」は諦めて「続きがあるか」だけ知る
総件数そのものを諦めるという選択肢もあります。上限より1件多く取得し、その1件が返ってきたかどうかで「続きがあるか」だけを判定するやり方です。
const LIMIT = 1000;

function listOrders(db) {
  const rows = db.prepare(
    "SELECT id FROM orders WHERE status = 'open' ORDER BY id LIMIT ?").all(LIMIT + 1);
  const hasMore = rows.length > LIMIT;
  const items = hasMore ? rows.slice(0, LIMIT) : rows;
  return { items, hasMore };
}
境界をまたいで試すと、ちょうど上限と同じ件数のときと、それより1件でも多いときとで、判定がきれいに分かれます。
実データ    0 件 -> items    0 件, hasMore=false
実データ  999 件 -> items  999 件, hasMore=false
実データ 1000 件 -> items 1000 件, hasMore=false
実データ 1001 件 -> items 1000 件, hasMore=true
実データ 3500 件 -> items 1000 件, hasMore=true
ここで、もう1つ確かめておきたいことがあります。「返った件数が上限と同じなら、切れているかもしれない」という簡易判定を思いつく人もいるはずです。母集団の件数を持っていないときの次善策として、悪くない発想に見えます。
ですがこの判定は、母集団がちょうど上限件数だけ存在するときに誤作動します。実データが 1000 件(上限ちょうど)の行を見てください。母集団はぴったり届いているのに、「件数=上限」という条件には当てはまってしまいます。limit + 1 件を実際に取りに行けば、この境界も含めて正しく判定できます。1件よけいに取るだけの単純な方法ですが、境界での誤判定を避けられるのはここが理由です。
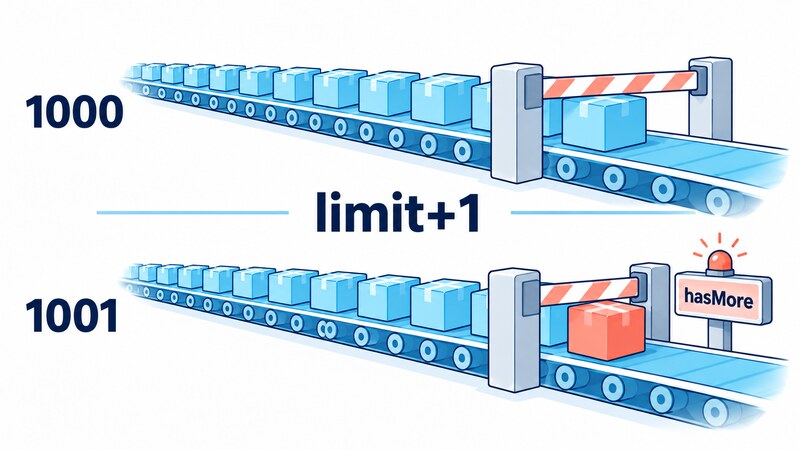
limit + 1 は、上限ちょうどと上限超えを1件の差で見分ける次ページトークンで「続きがある」を伝える
limit + 1 は自前で実装できる軽量な方法ですが、公開 API の設計としては、もう1段抽象化した方式が広く採られています。Google の API 設計ガイドライン AIP-158 は、一覧 API のページングについて次のように定めています。
The API may return fewer results than the number requested (including zero results), even if not at the end of the collection.
If the end of the collection has been reached, the next_page_token field must be empty. This is the only way to communicate “end-of-collection” to users.
ポイントは、「続きがあるか」を件数では判定させないという設計です。返ってきた件数が要求より少なくても、それだけでは終端に達したとは限りません(1つ目の引用)。終端に達したかどうかを知る手段は、次ページを取得するためのトークンが空になっているかどうか、それだけです(2つ目の引用)。件数の多い少ないという「量」に頼らず、トークンの有無という「印」1つに絞り込んでいるわけです。
総件数フィールド自体についても、同じ文書は次のように位置づけています。
Response messages for collections may provide an int32 total_size field, providing the user with the total number of items in the list.
total_size は「あってもよい」(may)フィールドであり、必須ではありません。ページングの終端を伝える役目は、あくまで次ページトークンが担っています。この記事では、次ページトークンを使う具体的な実装コードまでは踏み込みません。ここでは「総件数と終端の判定を、別々の仕組みに分けて設計する」という考え方の地図として押さえておきます。
使う側・作る側の作法
ここまでの4つの方法を並べると、それぞれ得意・不得意がはっきりしてきます。
| 方法 | 総件数の正確さ | コスト | 「続きがあるか」の判定 | この記事での確認区分 |
|---|---|---|---|---|
| 返した配列の長さ / LIMIT後に数える | 上限で切れると誤り | 追加コストなし | できない | 実測 |
別クエリで count(*) |
数えた瞬間は正確、その後の増減はずれる | 中程度 | 別途 limit + 1 などが要る |
実測 |
COUNT(*) OVER () |
正確(行が0件だと取れない) | この環境では別クエリより重い | 別途要る | 実測 |
limit + 1 で hasMore |
総件数は分からない | ほぼ追加コストなし | 境界まで含めて正確 | 実測 |
| 次ページトークン | 任意(total_size は may) |
実装依存 | トークンの有無で判定 | 仕様の記述 |
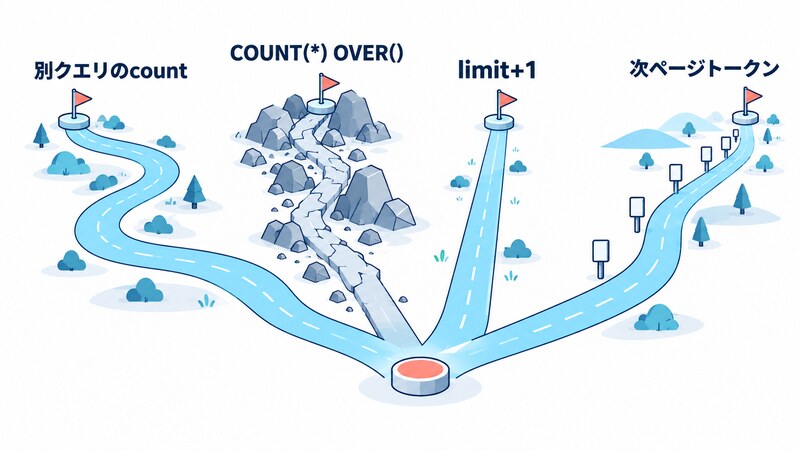
このうえで、使う側と作る側、それぞれに1つずつ持ち帰れることがあります。
一覧 API を作る側は、上限に到達したことが分かったら、それを画面の言葉にして伝えるのがよさそうです。「これで全部です」ではなく、「上限までの表示です。条件を絞ってください」のように、切れている可能性そのものを利用者へ渡します。そして total というフィールド名を API 契約に書くときは、それがどこで数えた値か(母集団か、返した件数か)まで明記します。名前だけでは、呼び出し側にはどちらなのか判断できません。
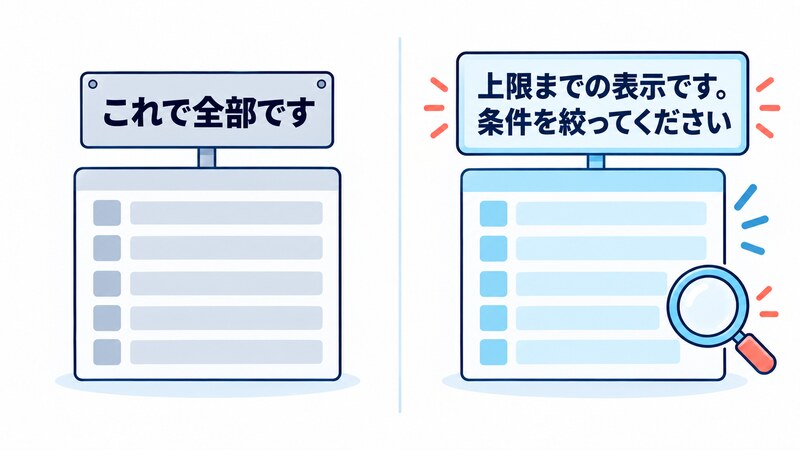
一覧 API を使う側は、要求した limit が黙って上限へ丸められることがある、という前提で読んでおくと安心です。AIP-158 や GitHub の REST API のドキュメントは、どちらも「上限を超える page_size はエラーにせず、上限へ丸めてよい」と明記しています。
If the user specifies page_size greater than the maximum permitted by the API, the API should coerce down to the maximum permitted page size.
If you specify a value greater than the maximum, GitHub does not return an error. Instead, the value is automatically reduced to the maximum
丸めること自体は、複数の公開 API が採用している正当な設計です。問題にすべきは丸めではなく、丸めた結果として「続きがある」ことをどう伝えるか、そのセットのほうです。上限へ丸めているのに、それを伝える信号を持たない API は、この記事の冒頭の実装と同じ穴を抱えています。
まとめ
total という同じ名前のフィールドでも、どこで数えたかによって意味はまったく違います。items.length や「LIMIT した後の count(*)」は、上限の内側しか見ていません。COUNT(*) OVER () や別クエリの count(*) は母集団まで届きますが、それぞれに別の癖(行が0件だと消える、数えた瞬間の値でしかない、この環境では重い)を抱えています。
総件数を諦めて limit + 1 件を取りに行けば、上限ちょうどの境界も含めて「続きがあるか」だけは確実に判定できます。さらに一段抽象化したければ、AIP-158 が定める次ページトークンのように、件数ではなく「印」で終端を伝える設計もあります。
自分が今使っている一覧 API の total が、どこで数えられた値なのか、次に見るときに確かめてみてください。答えがすぐに出ないなら、その total はまだ何も教えてくれていない可能性があります。
参考にした一次情報
- PostgreSQL 公式ドキュメント — Queries: LIMIT and OFFSET(
LIMITが「最大でその件数」を返すこと、ORDER BYが一意な順序に必要なこと) - PostgreSQL 公式ドキュメント — SELECT(
SELECTの処理順。ORDER BYの後にLIMIT/OFFSETが処理されること) - PostgreSQL 公式ドキュメント — Tutorial: Window Functions(窓関数が
WHERE/GROUP BY/HAVINGの後に評価されること) - Google AIP-158: Pagination(
page_sizeの丸め、total_sizeが任意フィールドであること、次ページトークンによる終端の伝え方) - GitHub Docs: Using pagination in the REST API(上限を超える値の丸めについての実例)