
Jev の confidence 0.9 は何を測っているのか:連載 第 3 回
confidence は「当てずっぽうからの道のり」であって最大確率そのものではない。選択肢を足すと確率も動く。公開式と実測で読み解く
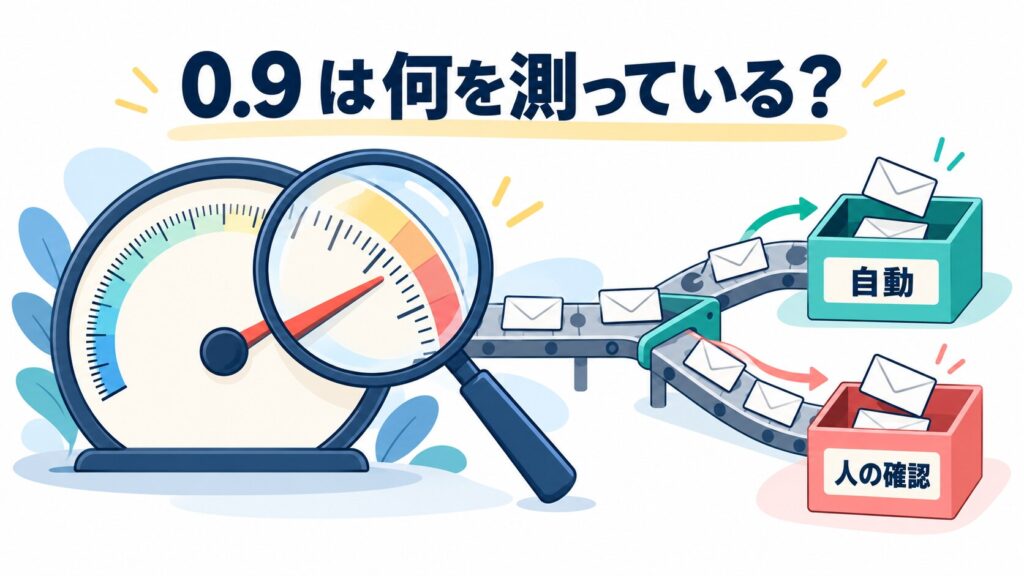
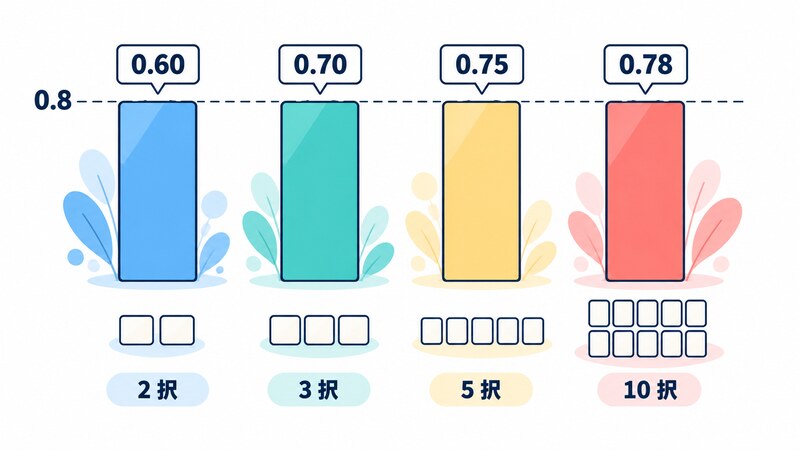
一番高い確率が同じ 0.8 でも、選択肢の数しだいで confidence は 0.60〜0.78 と動きます。confidence は一番高い確率そのものではなく、「当てずっぽうから確実までの道のりのどこまで来たか」を測る数です
AI に問い合わせ文を読ませて、担当チームを自動で振り分けたいとします。多くの人は、まず「AI が返す確信度(confidence)が 0.9 以上なら自動で処理し、それ未満なら人に回す」というルールを思いつくはずです。この 0.9 のように、自動で処理するか人に回すかを分ける境目の数字を、閾値(しきい値)と呼びます。ところで、この 0.9 は、いったい何を測っているのでしょうか。
この記事では、TypeSafe AI が公開している判定モデル Jev の API を実際に呼びながら、confidence が何から計算され、何を見ていないのかを順に確かめます。式は出てきますが、必ず手計算の例と、ひとことの言い換えを添えます。確率や統計の知識は要りません。
目次
Jev を数分で:文章ではなく、型のある答えと確率が返ってくる
Jev は、文章を書く AI ではありません。判定したい文章(state)と質問を渡すと、質問に合った型の答えと、その確率を JSON で返します。質問の型は 3 種類に決められています。
- Choice: 選択肢から 1 つ選ぶ(例: 担当チームはどれか)
- Score: 段階の数直線のどこにあるかを答える(例: 書き手の苛立ちは、落ち着いている・やや不満・強い不満のどれか)
- Noul: 「はい」である確率を 1 つ答える(例: 書き手は返金を求めているか)
3 つの型を 1 回の呼び出しでまとめて聞いてみます。問い合わせ文は記事用に作った架空のものです。
import { choice, noul, score, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient({ apiKey: process.env.JEV_API_KEY });
const { answers, model } = await client.systemOne({
  state: "APIのレスポンスが急に10秒以上かかるようになりました。原因は請求の問題でしょうか?",
  questions: {
    team: choice("担当チーム", {
      billing: "支払い・契約",
      technical: "不具合・連携",
      sales: "価格・アカウント",
    }),
    frustration: score("書き手の苛立ち", ["落ち着いている", "やや不満", "強い不満"]),
    refund: noul("書き手は返金を求めている"),
  },
});
返ってきた答えは次のとおりです(モデルは jev-1.13.0。各段のラベル(legend)は省略しています)。
{
  "team": {
    "type": "choice", "choice": "technical", "confidence": 0.86,
    "probabilities": { "billing": 0.09, "technical": 0.91, "sales": 0 }
  },
  "frustration": {
    "type": "score", "score": 0.82, "confidence": 0.7,
    "probabilities": { "0": 0.19, "1": 0.8, "2": 0.01 }
  },
  "refund": { "type": "noul", "noul": 0.1 }
}
Choice と Score の答えには、確率の一覧(probabilities)と、それを 1 つの数にまとめた confidence が付いています。一方、Noul には confidence がありません。この違いにも理由があり、後ほど説明します。
Choice の confidence:当てずっぽうから、どれだけ離れているか
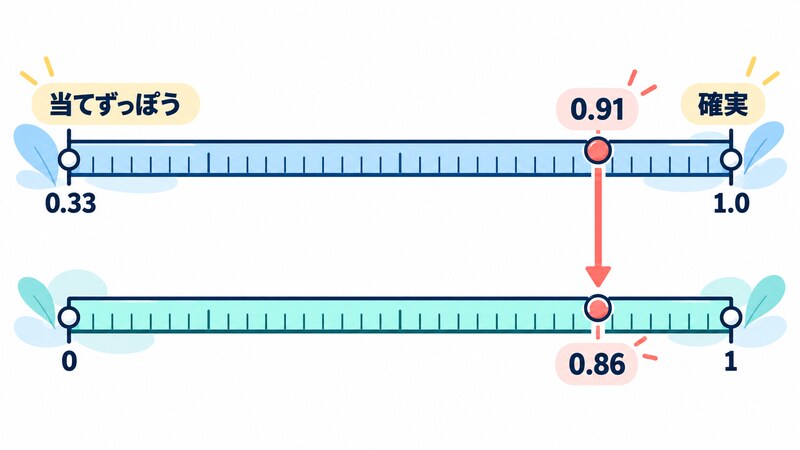
まず Choice です。上の team は、technical の確率が 0.91 で、confidence は 0.86 でした。0.91 より小さいのはなぜでしょうか。
公式ドキュメントが公開している式は、次のとおりです。n は選択肢の数、p は一番高い確率です。
confidence = (p − 1/n) / (1 − 1/n)ひとことで言うと、当てずっぽう(全選択肢に同じ確率を配った状態)を 0、100% の確実を 1 として、一番高い確率がその間のどこにいるかを測る式です。3 択の当てずっぽうは各 1/3(約 0.33)なので、そこから 1 までの道のりを 0〜1 に引き伸ばしています。
手で計算してみます。team は n = 3、p = 0.91 なので、(0.91 − 0.333) ÷ (1 − 0.333) = 0.577 ÷ 0.667 ≒ 0.865 になります。API が返したのは 0.86 で、ほぼ同じです。0.005 ほどのずれは、API が返す確率が小数 2 桁に丸められている一方、confidence は丸める前の確率から計算されているためだと考えられます。手元で再計算すると、最大で 0.005 ずれます。
この式は、本当にサーバーの答えと合うのでしょうか。架空の問い合わせ 8 件に 9 個の質問(Choice は 2・3・5・7・10 択、Score は 3・4・5 段、Noul は 1 個)を聞き、Choice と Score の合計 64 個の答えを、返ってきた確率から式で計算し直して突き合わせました。結果は、64 個すべてが 0.015 以内、最大のずれは 0.005 でした。小数 2 桁まで丸めて完全に一致したのは 53 個で、残りは丸めの差です。
ただし、これは「公開されている式が、観測された答えを再現する」ところまでの確認です。サーバーの内部は非公開なので、実際にその式で計算しているかどうかまでは、外からは確かめられません。
落とし穴 1:同じ 0.9 でも、要る最大確率は選択肢の数で少し動く
式を見ると、1/n が入っています。つまり confidence は、選択肢の数 n に合わせて当てずっぽうの位置を引き直した尺度です。「当てずっぽうから確実までの道のりの何割か」という意味は n によらず同じですが、一番高い確率(最大確率)そのものとは 1 対 1 に対応しません。
一番高い確率がどちらも 0.8 のとき、confidence はこうなります(残りの 0.2 は他の選択肢に等分したとして計算)。
| 選択肢の数 | 2 | 3 | 5 | 10 |
|---|---|---|---|---|
| confidence | 0.60 | 0.70 | 0.75 | 0.78 |
逆に、confidence が 0.9 以上になるために一番高い確率(最大確率)がいくつ要るかを計算すると、2 択では 0.95、3 択では 0.93、5 択では 0.92、10 択では 0.91 です。同じ「0.9 以上」でも、要る最大確率は 0.91〜0.95 と少し動きます。公式ドキュメントも、最大確率そのものを閾値にする場合は、選択肢の数で意味が変わるので質問ごとに決めるよう書いています。
なお、最大確率は「AI がそう見ている度合い」であって、実際に当たる割合と同じとは限りません。当たり具合は、この記事では測っていません。
もう一つ、見落としやすい点があります。Choice の confidence は、一番高い確率しか見ません。2 番手以下がどう分かれていても、数字は変わらないのです。
3 択で一番高い確率が 0.6 のとき、残りの分け方を変えて式を当てました。
| 確率の分け方 | confidence |
|---|---|
| 0.6 / 0.4 / 0 | 0.40 |
| 0.6 / 0.2 / 0.2 | 0.40 |
| 0.6 / 0 / 0.4 | 0.40 |
最初の行は「2 つの候補で迷っている」状態、2 行目は「残りが散らばっている」状態ですが、confidence は区別できません。公式ドキュメントは、最大確率のほかに、1 位と 2 位の確率の比(p_max ÷ p_second)も代わりの指標として挙げています。上位 2 つの勝負が大事な判断では、この比が効きます。
落とし穴 2:選択肢を足すと、確率そのものが動くことがある
次は、もう少しやっかいな話です。式の 1/n が変わるだけなら、その分を計算で補正できます。ところが、選択肢を足すと確率そのものが動くことがありました。
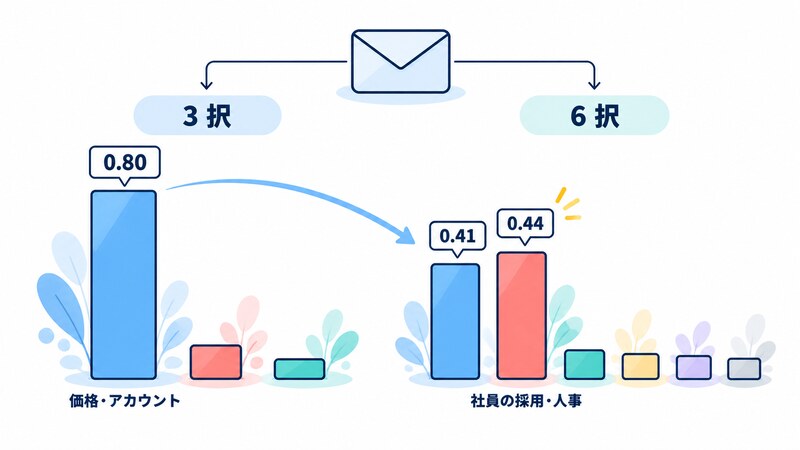
同じ問い合わせに、担当チームの 3 択と、その 3 択に「法務・契約書の審査」「社員の採用・人事」「オフィス設備」という明らかに関係のない選択肢を足した 6 択を、同じ呼び出しの中で並べて聞きました。実行前は、確率はほとんど動かず、confidence が少し上がる程度だろうと予想していました。なお、3 択と 6 択は同じ呼び出しの中で並べて聞いたので、互いに影響した可能性は確かめていません。
3 件のうち 2 件は、予想どおりでした。確率はほぼそのままで、confidence の動きも 0.01 以下です。ところが、「ユーザーを 3 人追加したいです。」は、予想が外れました。
| 1 位 | 最大確率 | 2 位 | confidence | |
|---|---|---|---|---|
| 3 択 | 価格・アカウント | 0.80 | 不具合・連携 0.18 | 0.70 |
| 6 択 | 社員の採用・人事 | 0.44 | 価格・アカウント 0.41 | 0.33 |
関係のない選択肢を足しただけで、答えが「社員の採用・人事」に変わりました。2 回実行して、1 位は 2 回とも同じでした(2 位の確率は 0.18 と 0.17 に揺れました)。1 位と 2 位の比は、3 択のとき 0.80 対 0.18(約 4.4 倍)だったのに、6 択では 0.44 対 0.41(約 1.07 倍)まで縮んでいます。
原因は確かめていません。推測ですが、「ユーザー」を「人」と読んで、採用の話に引っ張られたのかもしれません。いずれにせよ、選択肢を足すと確率そのものが動くことがあるので、足す前に決めた閾値をそのまま使い回してはいけません。選択肢を増減させたら、閾値は決め直しです。
Score の confidence:score の値とは別の情報
ここからは Score です。Score は、段階(レベル)を 0、1、2…と番号で並べたものの上で、答えを数字で返します。上の frustration は 3 段(0 落ち着いている、1 やや不満、2 強い不満)で、score は 0.82、confidence は 0.7 でした。
score は、段の番号に確率を掛けて足した、確率で重み付けした平均です(統計の言葉では期待値と呼びます)。frustration の確率は 0.19 / 0.8 / 0.01 なので、0×0.19 + 1×0.8 + 2×0.01 = 0.82 になり、返ってきた値と一致します。64 個の答えのうち Score の 24 個でも、score はこの計算と、小数 2 桁の丸めの範囲(最大 0.02)で一致しました。
では confidence は何でしょうか。公開されている式は、次のとおりです。
confidence = 1 − (一番ありそうな段からの、確率で重み付けした平均の離れ具合)
                 ÷ (全部の段に同じ確率が乗ったときの、真ん中の段からの平均の離れ具合)
(計算結果がマイナスになったら 0 とします)ひとことで言うと、答えが一番ありそうな段のまわりにどれだけ固まっているかです。割る数は「まったく固まっていない状態(全部の段に同じ確率が乗った状態)」の目安で、それと比べてどれだけ固まっているかを見ています。その状態には一番ありそうな段が決まらないので、真ん中の段を基準にしています。
frustration で手計算してみます。
一番ありそうな段は 1 です。そこからの離れ具合は、0 の段が 1 つ分離れて 0.19、2 の段が 1 つ分離れて 0.01 なので、0.19×1 + 0.01×1 = 0.20 になります。全部の段に同じ確率が乗ったときは、3 つの段の真ん中からの平均の離れ具合が (1+0+1)÷3 = 2/3 です。したがって 1 − 0.20 ÷ (2/3) = 0.70 で、返ってきた 0.7 と一致します。
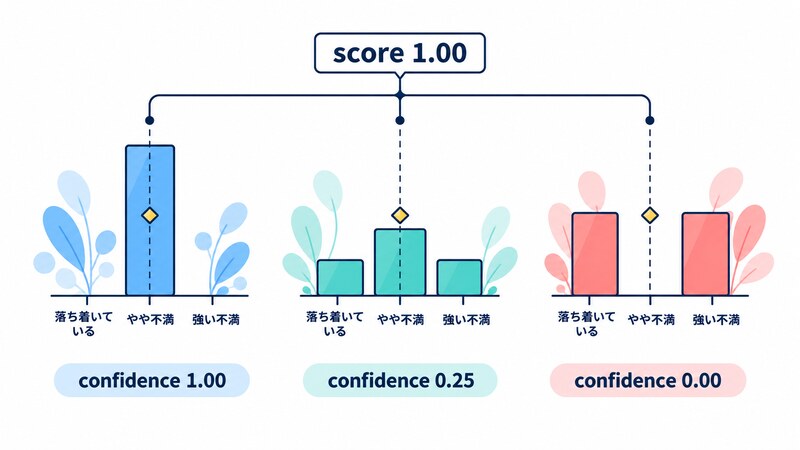
大事なのは、score と confidence が別の情報だということです。score がちょうど 1.00 になる、3 通りの確率の配られ方(分布)を比べます。
| 確率(0 / 1 / 2 の段) | score | confidence |
|---|---|---|
| 0 / 1 / 0 | 1.00 | 1.00 |
| 0.25 / 0.5 / 0.25 | 1.00 | 0.25 |
| 0.5 / 0 / 0.5 | 1.00 | 0.00(式で計算) |
3 行目の計算は、一番ありそうな段を 0 の段として(0 の段でも 2 の段でも離れ具合は 1.0 で同じです)、離れ具合が 0.5×0 + 0×1 + 0.5×2 = 1.0 です。したがって 1 − 1.0 ÷ (2/3) = −0.5 となり、マイナスなので 0 になります。
3 行目は「落ち着いている」と「強い不満」に半々で割れているのに、平均を取ると「やや不満」の 1.00 になります。score だけを見ていたら、この割れ方は見えません。confidence が 0 であることで、初めて「この平均は当てにならない」と分かります。
なお Score の式は、一番ありそうな段の隣に確率が乗っているときは、遠い段に乗っているときほど confidence を下げません。「やや不満」と「強い不満」で迷うのは、「落ち着いている」と「強い不満」で迷うよりまし、という考え方です。
Noul に confidence が無い理由
Noul の答えには、type と noul(「はい」である確率)しかありません。なぜ confidence が無いのでしょうか。
理由は、確率そのものが迷いを表しているからです。0.5 に近ければ迷っていて、0 や 1 に近ければ確信しています。たとえば先ほどの refund は 0.1 なので、「返金を求めていない」とかなり確信している状態です。
どうしても confidence のような数字が欲しければ、|2p − 1| で作れます。ここでの p は noul の値(「はい」の確率)で、縦棒 | | は符号を無視した値(絶対値)を表します。refund なら p = 0.1 なので、|2×0.1 − 1| = |−0.8| = 0.8 です。
この式は、式の上では 2 択の Choice の式と同じ形です。0 から 1 までのどの p でも、差はコンピュータの小数計算で必ず出る微小な誤差の範囲でした。
閾値の決め方
ここまでを踏まえて、閾値の決め方を整理します。「一つの数字を全部の質問に使い回す」のをやめることが、いちばんの要点です。
- Choice: 質問ごとに決めます。選択肢の数が違うと、同じ
confidenceに要る最大確率が変わるので、数が違う質問に同じ 0.9 を使い回さないでください。上位 2 つの競り合いが気になる質問は、最大確率や、1 位と 2 位の比を併用します。 - Score:
scoreの値とは別に、confidenceを見ます。平均が良さそうでも、両端に割れているだけかもしれません。 - Noul:
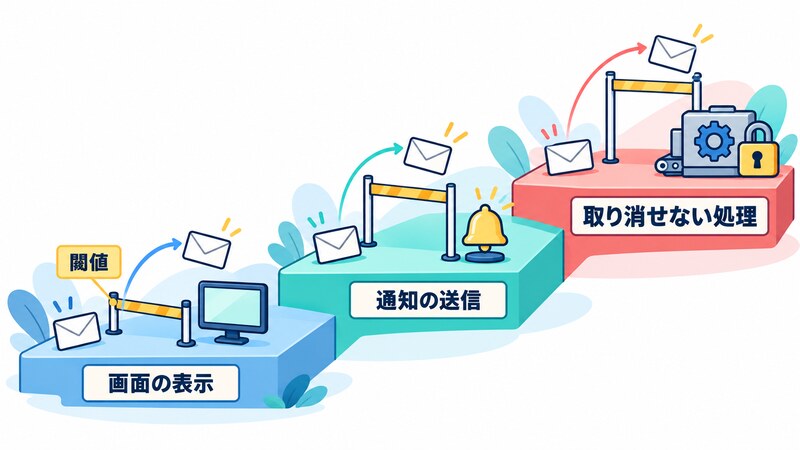
confidenceではなく、確率そのものに閾値をかけます。「はい」と言い切ってよい高い側と、「いいえ」と言い切ってよい低い側の、両端をそれぞれ決めます。その間は人に回します。 - 間違えたときの損失で変える: 公式ドキュメントは、閾値は一つの数ではなく、間違えたときの結果の重さに応じて変えるものだと説明しています。公式ドキュメントのコード例では、0.5 未満ならどの操作も人に回します。0.5 以上なら、残高の表示(画面の表示)はそのまま表示し、送金の承認(取り消せない処理)は 0.5〜0.9 では利用者に確認を求め、0.9 を超えると確認のうえで実行します。通知の送信のような中くらいの操作は公式の例にはありませんが、その間に置く、というのが筆者の例えです。ただし公式も、値は分野ごとに自分のデータで決めるものと書いているので、この数字を固定値として読まないでください。
そして最後に、忘れやすい注意が一つあります。confidence は確率を言い換えた数なので、確率そのものが歪んでいれば、confidence は歪みを直してくれません。
たとえば、「返金を求めている」と「返金を求めていない」は、同じ呼び出しで聞いても足して 1 になるとは限りません。架空の問い合わせ 4 件で、2 つの確率の和を調べると、0.87、1.01、0.90、0.93 でした。返金がはっきり書かれている文では 1 に近い一方、関係が薄い文では 0.87〜0.93 になっています。
この小さな検証は 4 件だけですが、確率が「正しさ」をそのまま表しているとは限らないことは分かります。閾値は、手元の実データで、実際の当たり外れを見ながら決めてください。公式ドキュメントも、保守的な値から始めて、自分のデータで確かめながら調整するよう書いています。
なお、公式の不得意ページ(Jev 1.13)には、否定語や条件の範囲を字面どおりに読むと書かれています。否定形の質問で確率が噛み合わなくても、不思議ではありません。
どう確かめたか、そして限界
確かめたのは、2026 年 10 月 19 日に jev-1.13.0(@typesafe-ai/sdk 0.7.0、Node.js v22.12.0)の本物の API を呼んだ結果です。値は呼び出しのたびに少し揺れるので、記事に載せた数字は、その回のものです。問い合わせ文は、すべて記事用に作った架空の文です。
- 8 件の問い合わせ × 9 個の質問で、Choice と Score の 64 個の答えが、公開式の再計算と 0.015 以内(最大 0.005)で一致しました。Noul の答えは
typeとnoulだけでした - 選択肢を 3 つ足す実験は 3 件だけで、1 件で答えが変わりました。原因の推測は確かめていません
- 否定形の確率の和の実験は 4 件だけです
確かめていないことも書いておきます。サーバー内部のソースは非公開なので、実際にその式で計算しているかどうかは分かりません。確率そのものの当たり具合(確率が「7 割」と言ったとき、本当に 7 割当たるのか)も測っていません。
まとめ:閾値を決める前のチェックリスト
- [ ] Choice の
confidenceは、一番高い確率が当てずっぽうからどれだけ離れているかを測る。2 番手以下の分かれ方は見ない - [ ] 選択肢の数が違えば、同じ最大確率でも
confidenceが変わり、同じconfidenceに要る最大確率も変わる。質問ごとに閾値を決める - [ ] 選択肢を足したり減らしたりしたら、確率も変わりうる。閾値を決め直す
- [ ] Score の
confidenceは、一番ありそうな段のまわりに固まっているかを測る。scoreの値とは別の情報 - [ ] Noul に
confidenceは無い。確率そのものに閾値をかける - [ ] 閾値は、間違えたときの重さで変える。まず保守的に始め、手元のデータで調整する
- [ ]
confidenceは確率の言い換えなので、確率の歪みは直らない
冒頭の問いに戻ります。「confidence が 0.9 以上」の 0.9 は、一番高い確率が当てずっぽうから確実までの道のりの 9 割まで来ている、という意味です。最大確率でいえば 0.91〜0.95 と動き、その最大確率が実際の当たる割合と同じとも限りません。その尺度を知ったうえで閾値を置くのが、自動処理を安心して任せる第一歩です。
連載の他の回
- Jev を使ってみた:文章を書かない AI に、型と確信度で判定させる(連載 第 1 回)
- Jev と Jev 互換のオープンソースモデルを比べてみた:Laya・Kev・Von を MacBook で動かす(連載 第 2 回)
参考にした一次情報
- Confidence(公式ドキュメント)(Choice・Score・Noul の式、最大確率と 1 位/2 位の比、閾値はリスクで変えること。2026-10-19 に確認)
- Primitives(公式ドキュメント)(Choice・Score・Noul の 3 つの型)
- Confidence-gated routing(公式ドキュメント)(確信度で処理を振り分けるパターン)
- Jev 1.13 jaggedness(公式ドキュメント)(Jev の不得意な点。否定語の扱いなど)
- system-one-adapter-python(GitHub)(公式の Python アダプタ。式の実装、MIT ライセンス)
- @typesafe-ai/sdk(npm)(呼び出しに使った SDK)